阅读预计 2 分钟
刚刚,SpaceXAI 正式发布全新旗舰模型 Grok 4.7,主攻编程和复杂知识工作。
官方定位是,加量不加价,速度不减,但比上一代 Grok 4.6 明显更扛打。
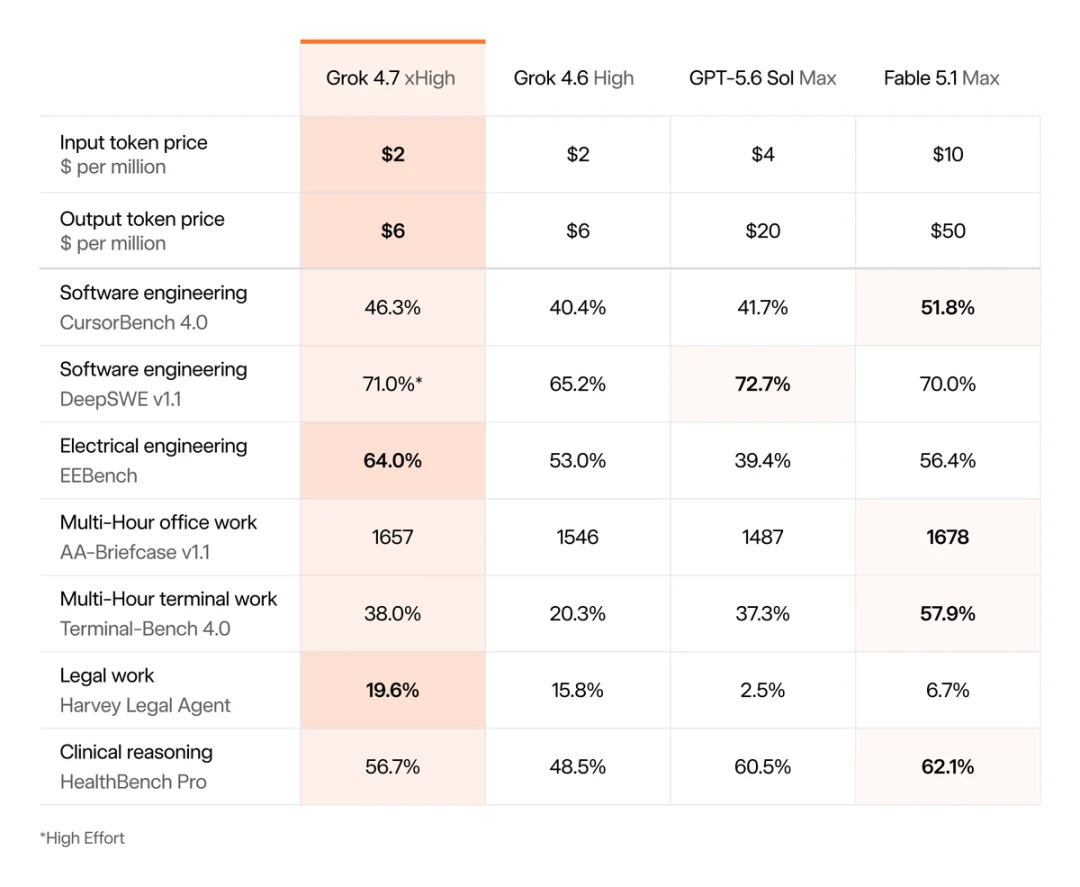
官方这次把 Grok 4.6、GPT-5.6 Sol Max、Fable 5.1 Max 对比,价格和主要 benchmark 如下:
重点有这么几项:
- 编程能力上,分数提升巨大。
Terminal-Bench 4.0 这项考的是连续几个小时的终端操作,Grok 4.7 从上一代的 20.3% 直接跳到 38.0%,快翻倍了,还反超了 GPT-5.6 Sol Max 的 37.3%。
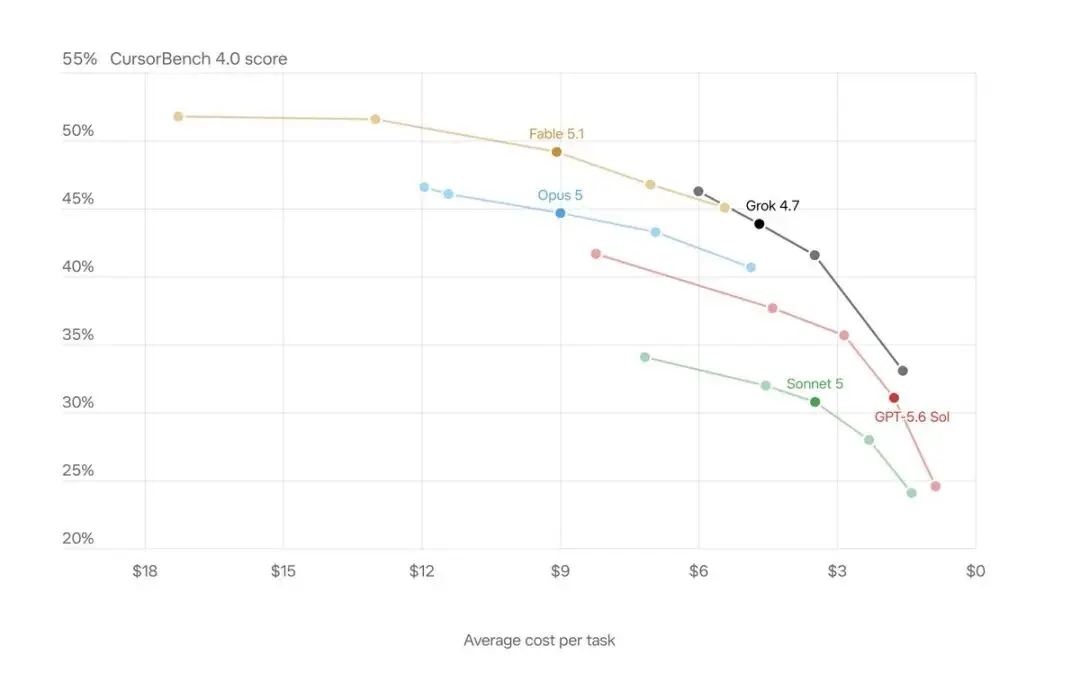
CursorBench 4.0 同理,也压过了 GPT-5.6 Sol 的 41.7%,只是离更贵的 Fable 5.1 Max 的 51.8% 还差一截。
- 法律和电气工程这两项居于第一名。
Harvey Legal Agent Benchmark 上 Grok 4.7 拿到 19.6%,是表里最高的;EEBench 电气工程 64.0%,
- 模型性价比高
把这些数字放进图表看,横轴是单任务平均花费,纵轴是 CursorBench 4.0 得分,Grok 4.7的模型花费显著低于Opus 5、Fable 5.1,但能力已经接近。
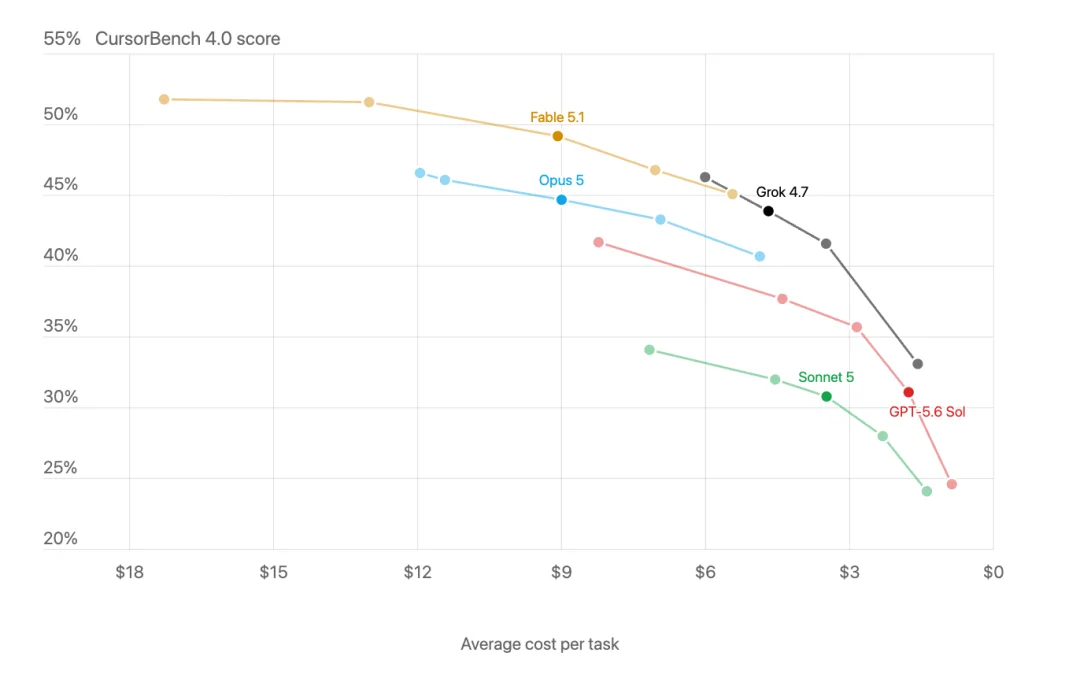
↑ CursorBench 4.0 价格-性能对比,Grok 4.7 明显把「同价位」这条线往上顶了一截
跳出编程这条线,GDPval 这项评测盯的是律师、护士、金融分析师这类专业岗位实际会做的文档和演示制作任务,用 Elo 分打分。
同样是柱状图,Grok 4.7 比上一代提升明显,几乎追平了Fable 5.1。
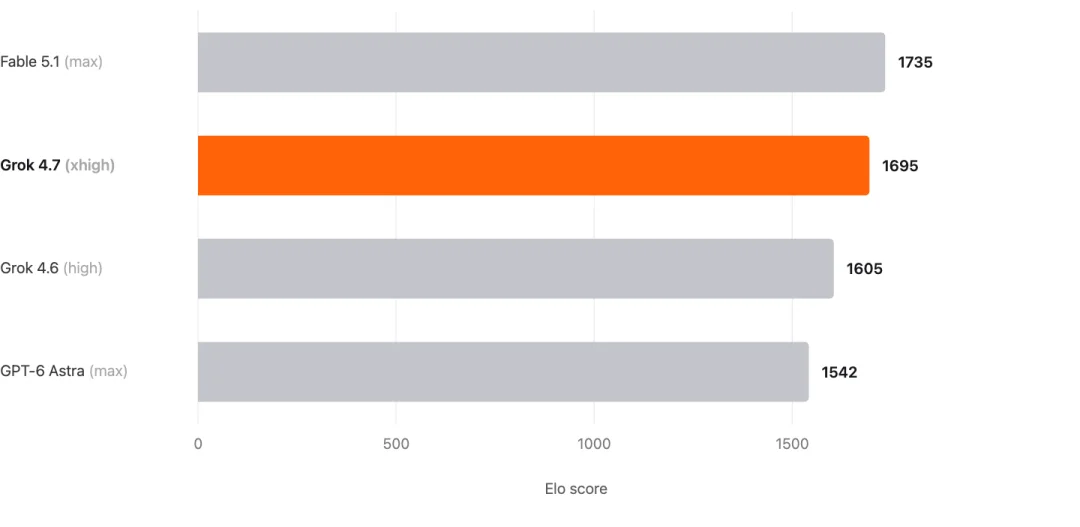
↑ GDPval 专业知识工作 Elo 分对比,Grok 4.7 追平了其他一线模型
不过,在第三方评测机构 Artificial Analysis 的综合榜单上,Grok 4.7 的排名相对落后。
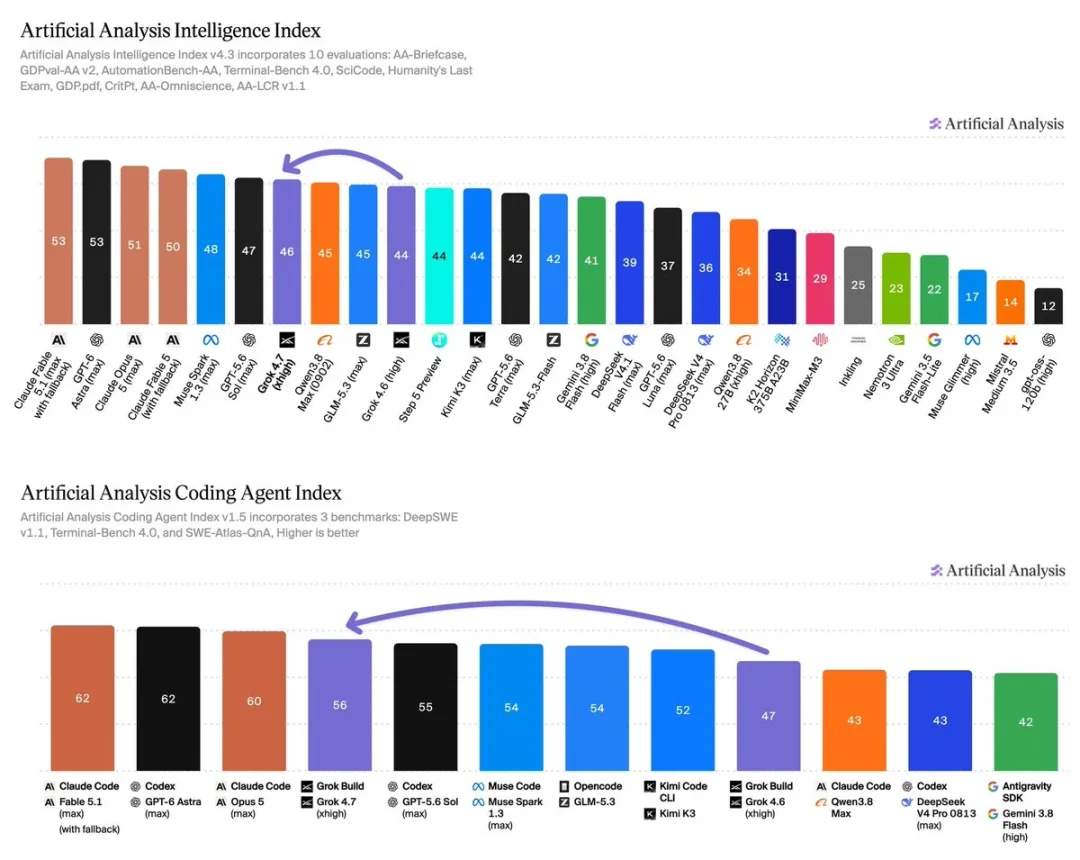
整体看,几乎打平GPT-5.6 sol。
◈安全这块,这次也大改了一版
Grok 4.7 用了一整套全新的安全防护体系,官方说这是他们测试过在拒绝有害请求和抵抗越狱攻击上最强的一版。
在网络安全能力上,HackerBench v0.3(专门测risky和恶意网络安全任务的榜)上,Grok 4.7 只放行了 3.3% 的高风险双用途请求,同时很少误伤正常的安全工作。
生物安全方向的 LatchBio 基准上拿到 62.4%,也是目前测过的模型里最高的。
最值得注意的一点:Grok 4.7 没涨价。
输入 2 美元 / 百万 token,输出 6 美元 / 百万 token,跟 Grok 4.6 完全一样。另外还有一个速度翻倍的 Fast 版本,价格也翻倍。
今天起,Grok 4.7 已经在 Cursor 和 Grok Build 里直接可用,同时开放 Grok API,也接入了第三方 coding harness、模型路由平台和云服务商。
◈实测效果
SpaceXAI 官方放出的对比演示,同样的开放世界城市游戏需求,分别丢给 Grok 4.7 和 Grok 4.6,看两者做出来的效果差距。
Grok 4.7 生成效果
Grok 4.6 生成效果(对照)
安全测试公司 XBOW 拿到 Grok 4.7 早期访问后,把它放进自己的漏洞挖掘流程。
结果发现,在固定迭代次数的 exploit crafting 测试里,4.7 略低于 4.6;
在 xAI 的 Grok Build 编排里,4.6 平均找出 42 个真实漏洞,4.7 找到 68 个,误报率也从 18.2% 降到 18.0%。同一张图里,外部 harness 下 4.6 是 72 个真实发现,4.7 是 65 个,误报率从 17.1% 升到 21.9%。
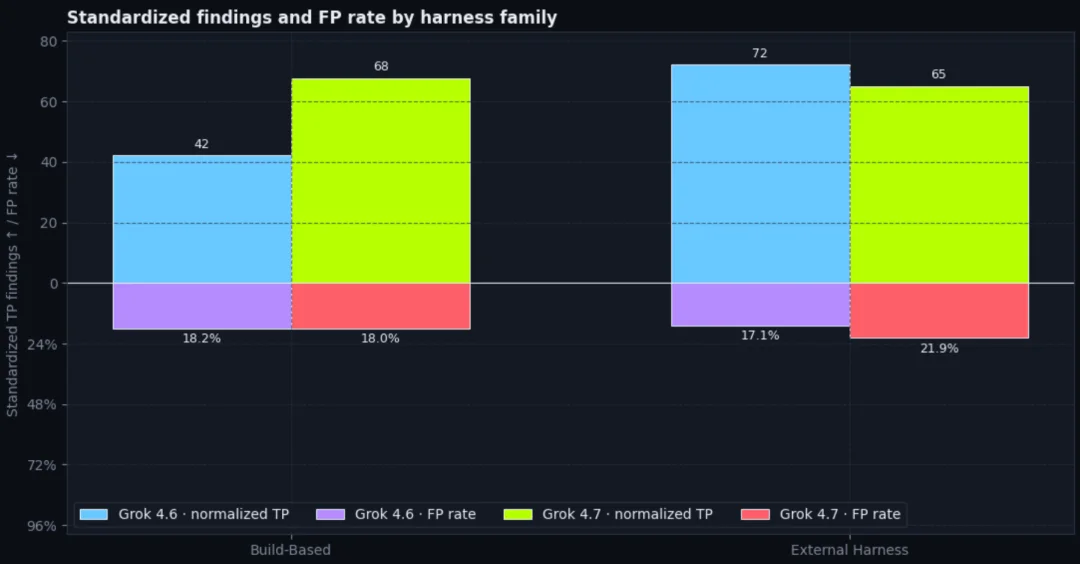
XBOW 对比 Grok 4.6 与 4.7 在不同 harness 中的真实发现数和误报率
4.7 更像是为 Build 这种短步执行、频繁看反馈的循环做了适配,它更常发出短命令。
社区风评方面,4.7 有一点陨落了。
大家实测发现,对于前端的一些问题解决得非常不到位,
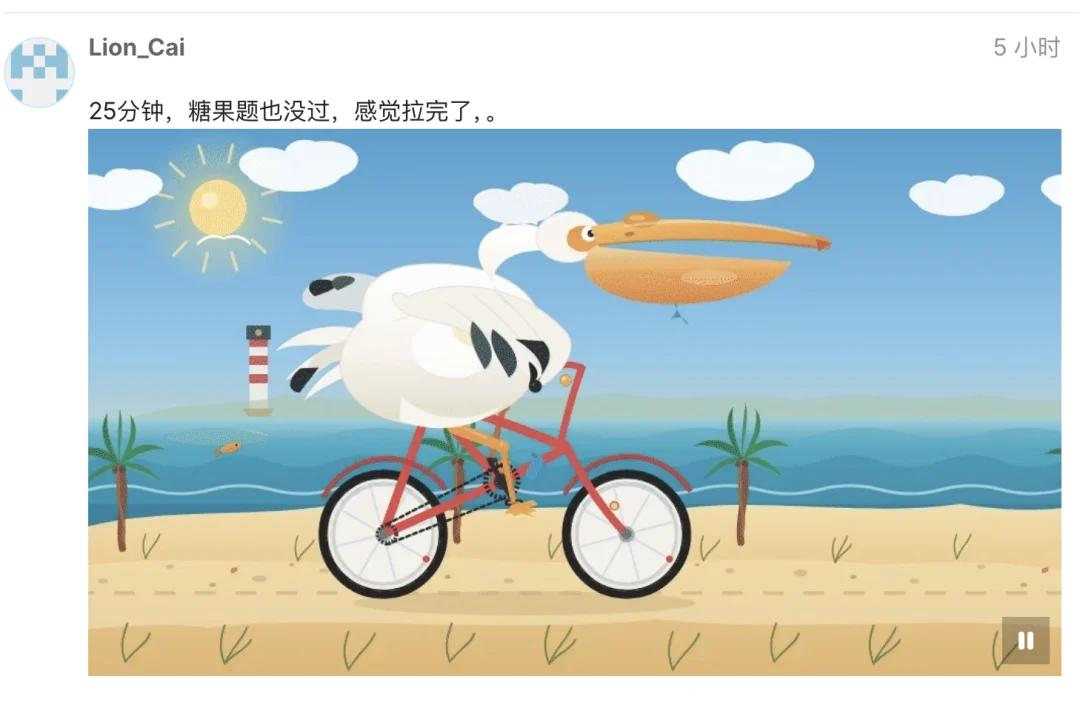
对于鹈鹕骑车、糖果测试的前端case,模型整体表现都很差。
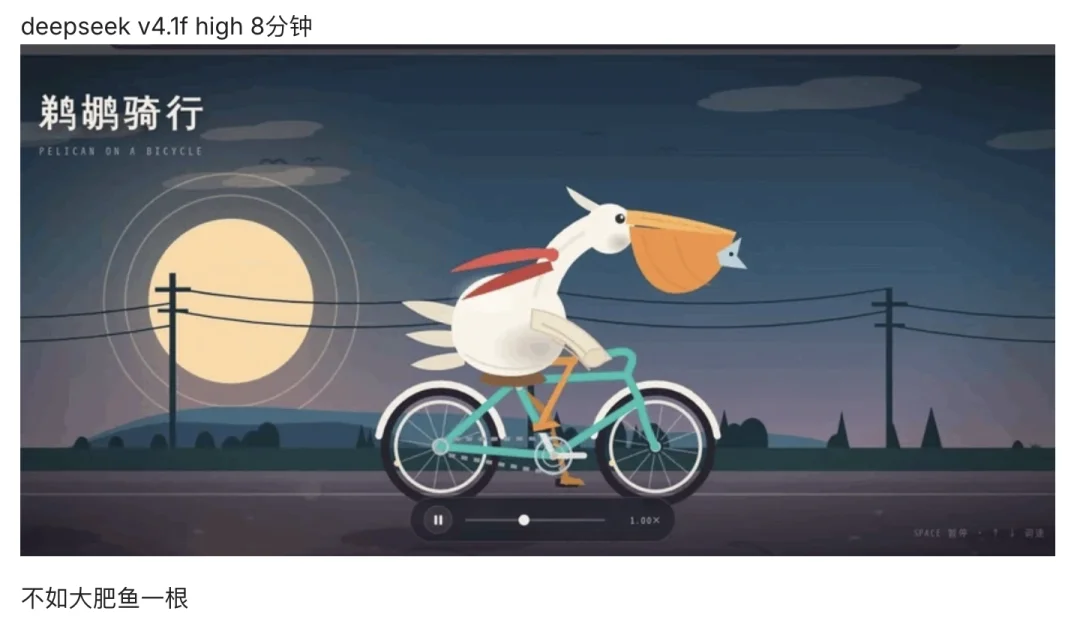
相比之下,甚至不如DeepSeek V4.1 flash效果好。
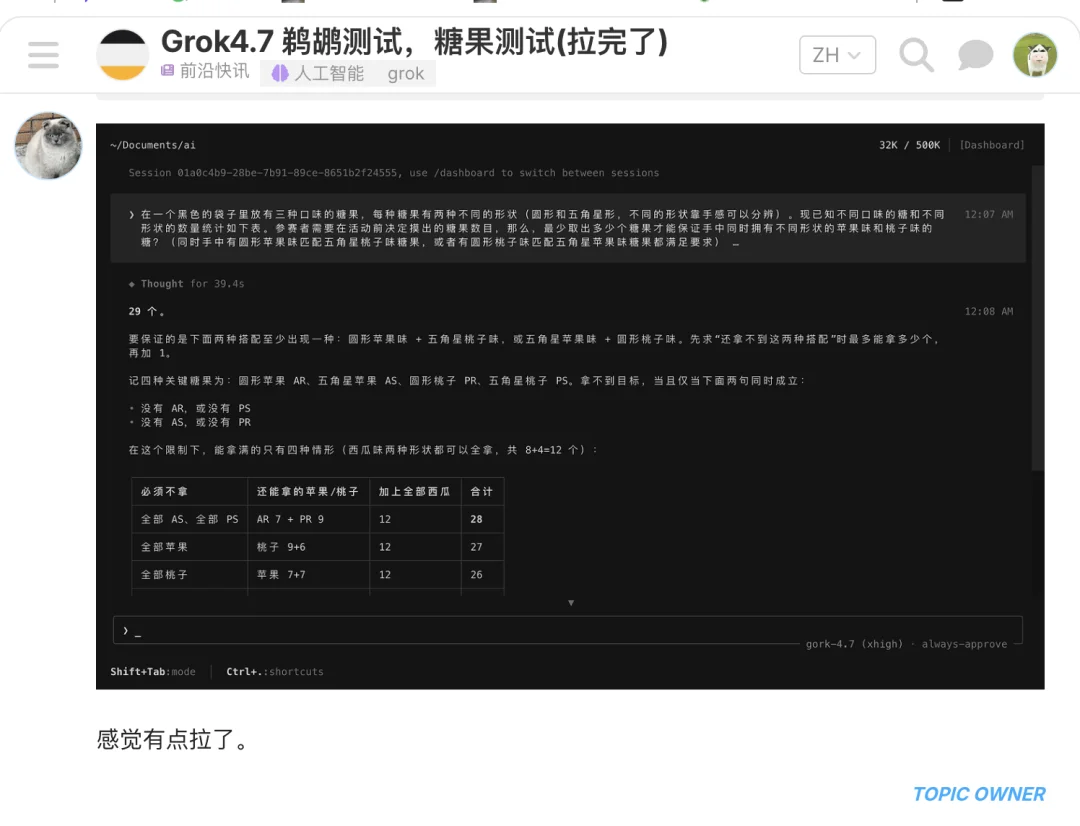
最后总结一下,Grok 4.7 更适合放进有工具、有反馈的长任务里。Grok Build、Cursor 这类编排方式能把它的优势放大,简单的一句话前端生成则未必占优。