阅读预计 7 分钟
哇哦哦哦,又热闹起来了。
Claude Opus 5.5刚发布,OpenAI 的 GPT-6 家族一口气补上两个新成员,GPT-6 Sol 和 GPT-6 Luna。
而且,新一代模型刚登场,价格直接腰斩上一代:Sol 和 Luna 的 API 单价,相比上一代至少减半。
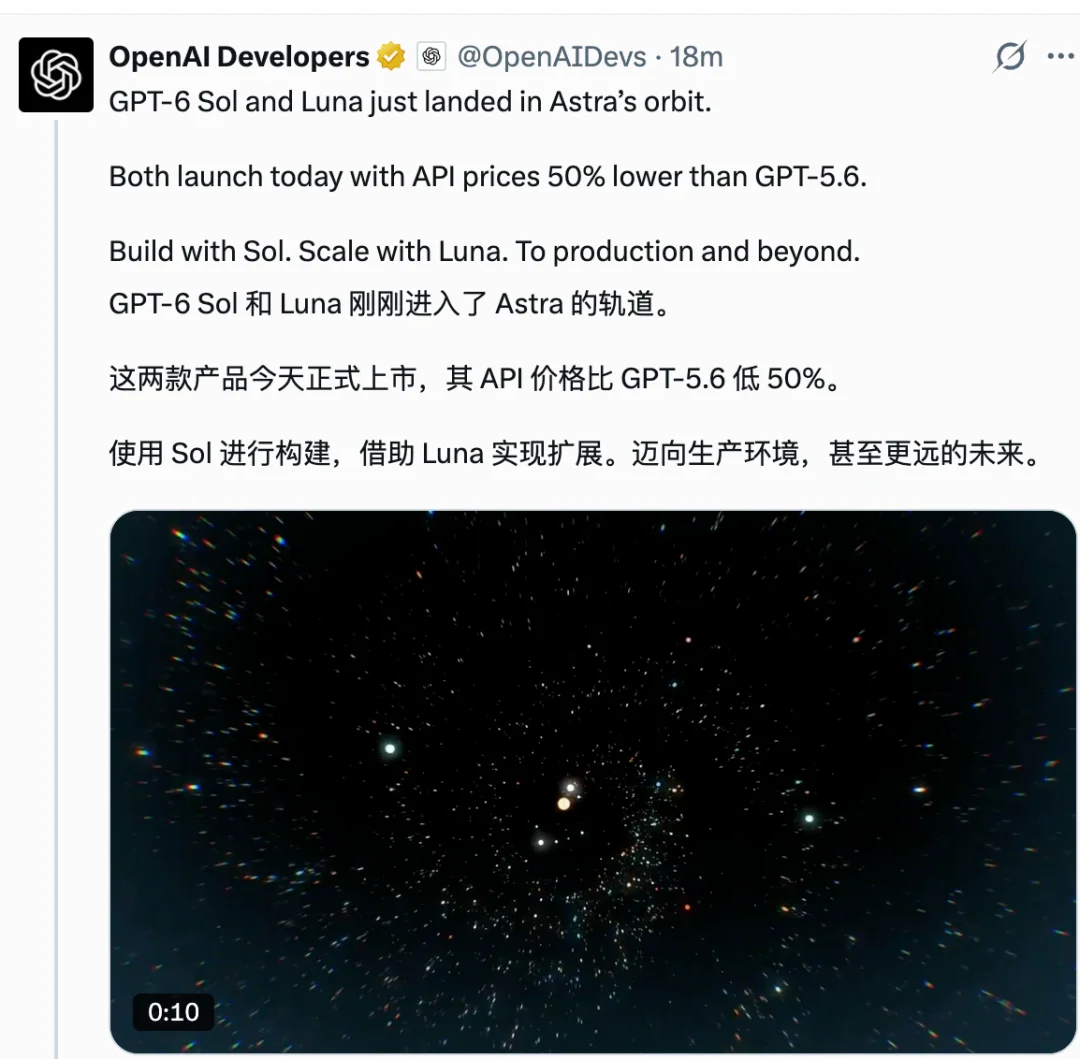
最便宜的 Luna,价格只有 Astra 的百分之一,甚至比 DeepSeek V4.1 Flash 的闲时价还低。
Codex负责人Tibo还顺手送了个福利,所有 Plus、Pro 和 Business 账户都会多一次额度重置。
不过,我们把官方曲线和第三方榜单对着看了一遍,这一代 Sol 和 Luna 的进步几乎全在“省钱”上。
Luna 在第三方榜单上的分数甚至还倒退了一点!!
下面我们一件件展开说。
◈1、Luna定价只要Astra的百分之一
先简单认一下。
GPT-6 现在分三档,九月初发布的 Astra 是顶配,这次的 Sol 是中杯,Luna 是小杯。
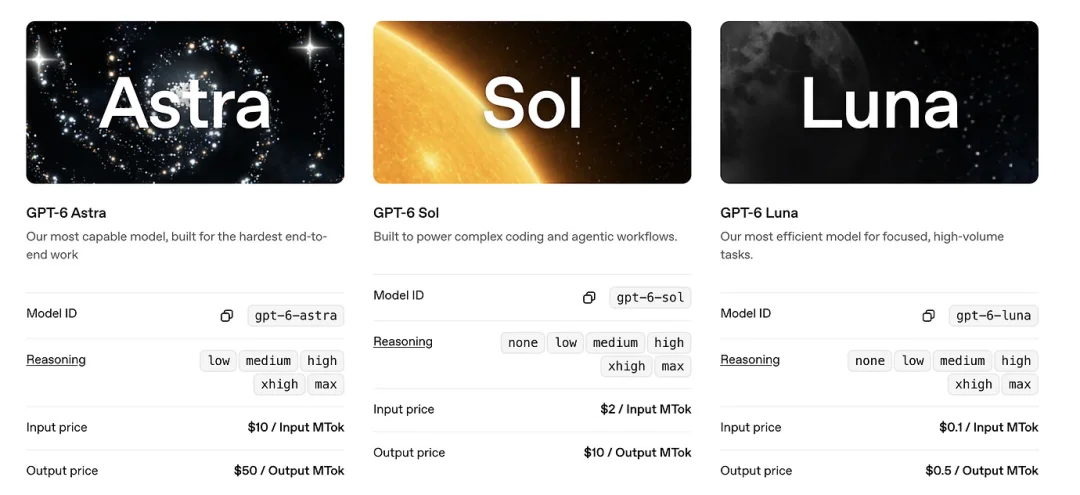
按每百万 token 算,Sol 输入2美元、输出10美元,Luna 输入0.1美元、输出0.5美元。Astra 则是输入10美元、输出50美元。
对比下来,Luna的输入和输出单价都正好是Astra的百分之一,Sol 是Astra的五分之一。
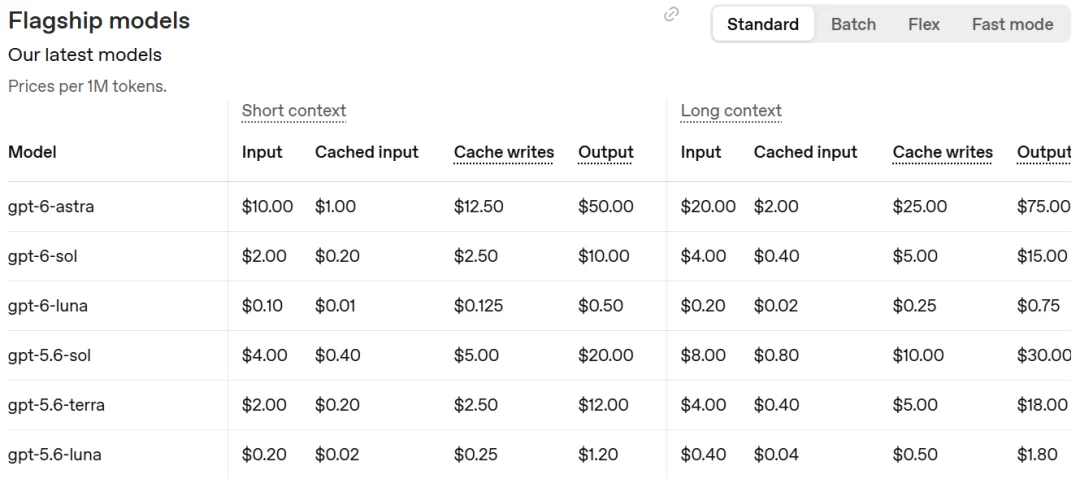
老天奶啊,Luna这是把价格卷进了无人区,比 DeepSeek 的闲时价还便宜。。。
DeepSeek V4.1 Flash的闲时价,是每百万token输入1元、输出4元(缓存未命中);而Luna按1美元约7.1元折算,输入大约0.7元、输出大约3.6元,比 DeepSeek 的闲时价还便宜。
只有缓存命中这一项,DeepSeek 的0.02元仍然更低。
另外,GPT的单次输入超过 272K token时,整次请求按输入2倍、输出1.5倍计费,Fast 模式价格翻倍。
还有一个省钱点是缓存。
智能体和长对话会反复带着同一大段上下文,缓存命中的部分只收一折。
这次 GPT-6 默认的缓存命中率更高,调整思考档位、开关工具不会让之前的缓存作废,开发者还能自己设断点,决定缓存到哪里为止。
◈2、官方成绩单,同样的分花更少的钱
价格砍半,能力有没有跟着缩水?OpenAI 放出的几项成绩,讲的都是同一件事,花同样的钱拿更高的分,或者拿同样的分花更少的钱。
先看企业自动化。AutomationBench 让 AI 调用 47 个工具,跑完销售、市场、运营、客服、财务、人事这些部门的完整业务流程。
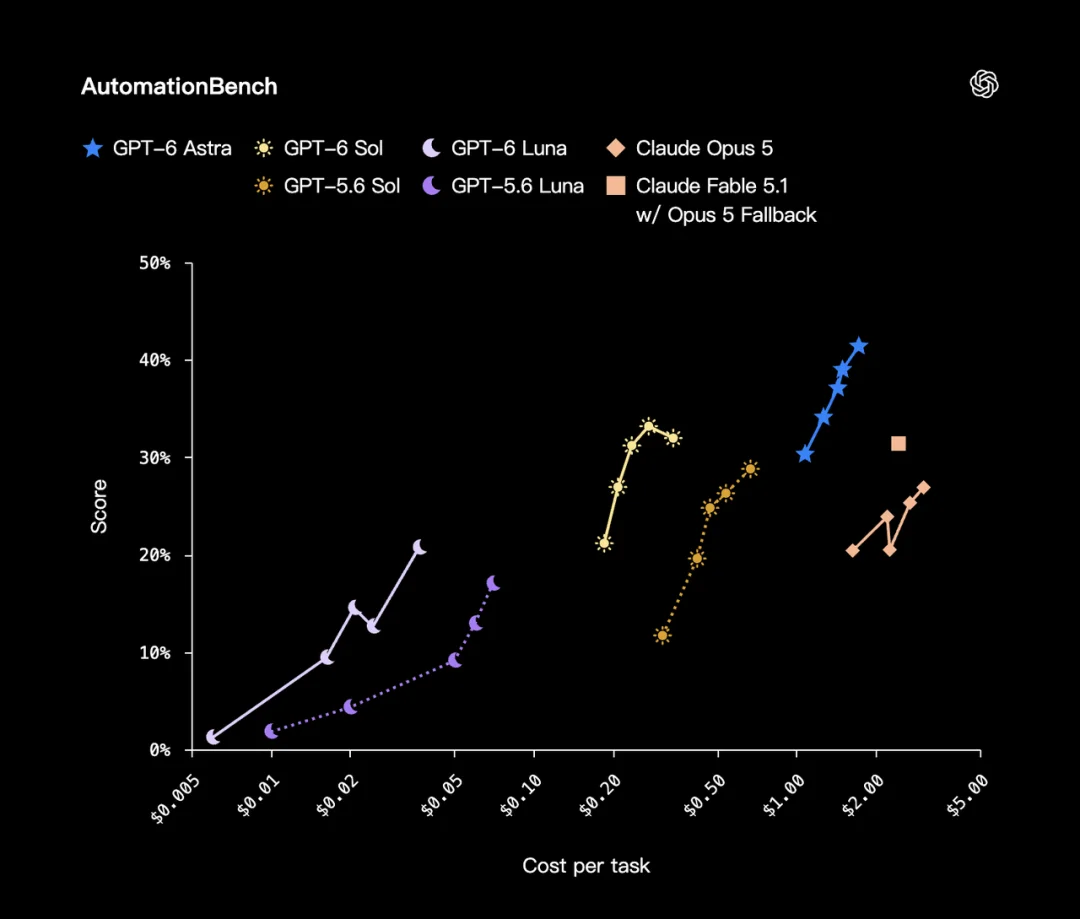
Sol 开 xhigh,一道题平均 0.27 美元,不到两块钱人民币。它比开满档的 Opus 5 高了 6 个多点,花费只有对方的九分之一左右,连低档位的自家大哥 Astra 都赢了。
Fable 5.1 的成绩要打个折看。这项测试里大约 40% 的题,Fable 5.1 转给了 Opus 5 兜底,兜底的花费 OpenAI 没算进去,所以它实际花的钱比表里写的更多。
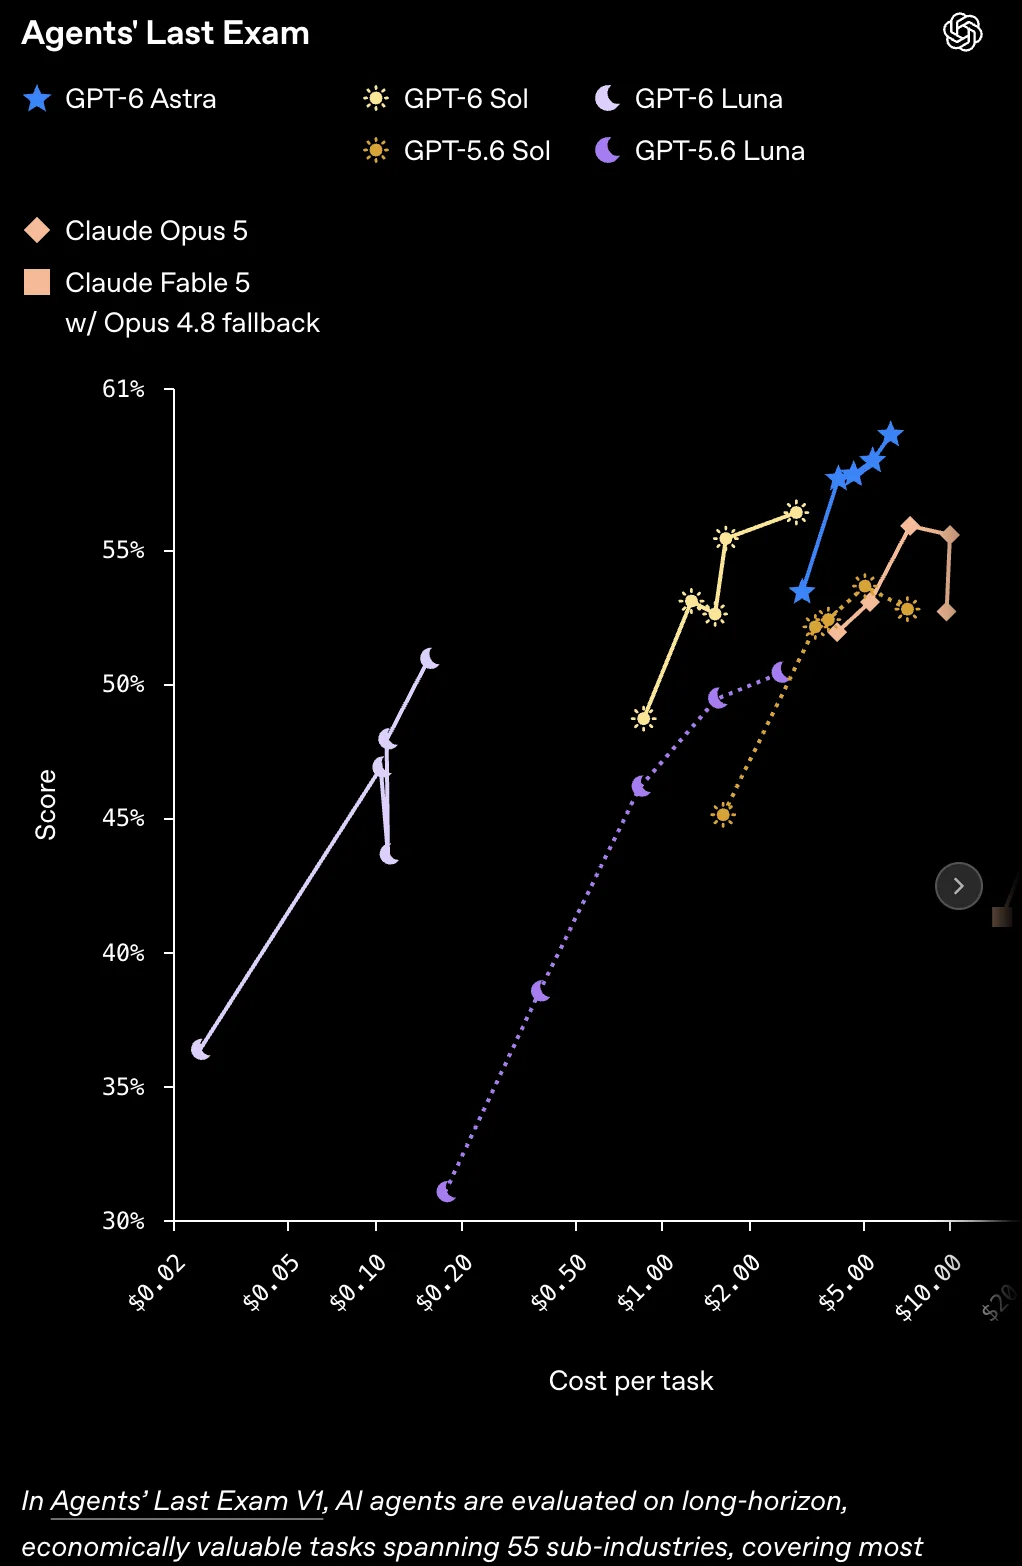
在覆盖 55 个细分行业的长流程专业任务测试 Agents’ Last Exam 上,Sol 开满档拿到 56.4%,超过 Opus 5 在这项测试里的最高分,每道题还便宜 60%。
写代码看 DeepSWE,它考的是在真实代码库里完成长流程的软件工程任务。官方给的是一张“花费-得分”曲线图,这种图后面还会出现,先说怎么读。
横轴是每道题的花费,用的是对数刻度,每往右一大格,价格翻好几倍;纵轴是得分。一条线是一个模型,线上每个点是它在不同思考档位下的成绩,档位越高越靠右上。实线是 GPT-6,虚线是上一代 GPT-5.6。越靠左上角,越便宜也越强。
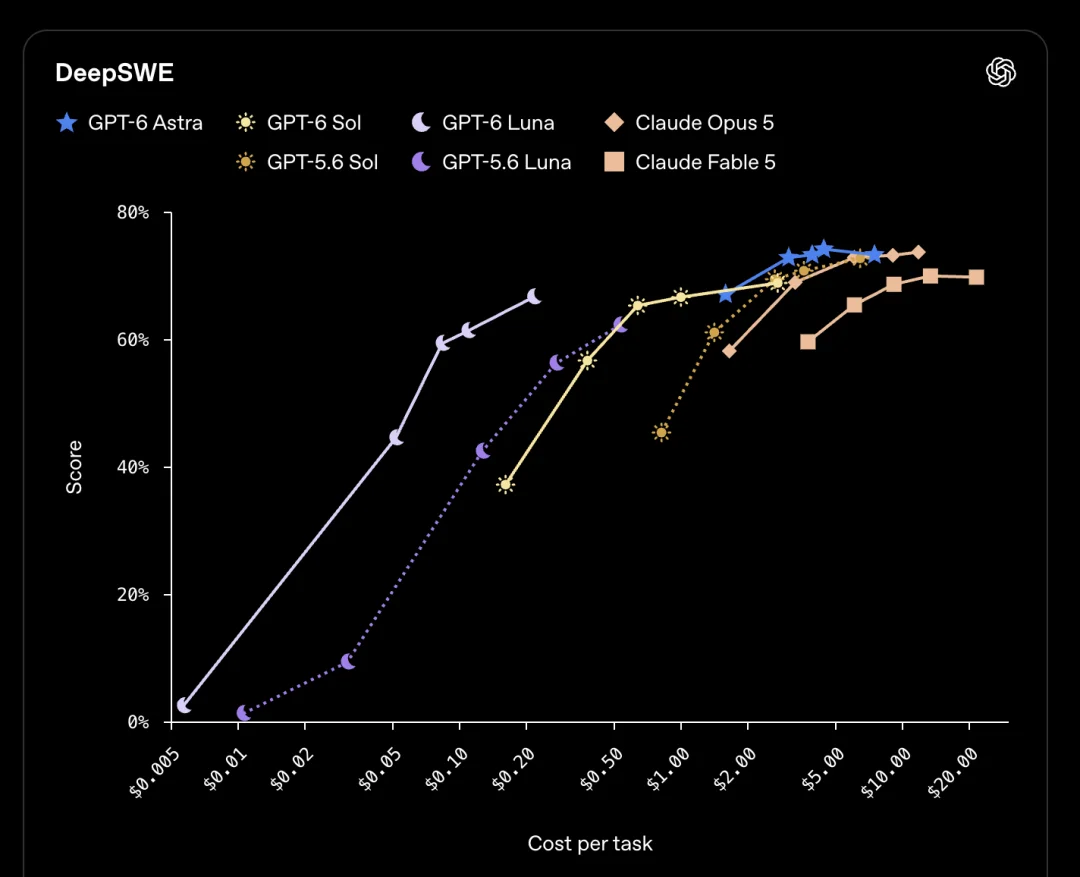
新 Sol 开满档拿到 68.8%,Claude Fable 5 在这项测试里的最高分是 69.9%,只差 1.1 个点,Sol 每道题却便宜了大约 80%。
Luna 更夸张。开满档拿到 66.6%,和 Opus 5、Fable 5 开中档差不多,每道题比 Opus 5 便宜 93%,比 Fable 5 便宜 96%。和老 Luna 比,同样做到六成左右的分数,新 Luna 一道题不到 0.1 美元,老 Luna 要 0.4 美元左右。
但这张图还藏着一个官方没提的细节。老 Sol 开满档大约能到 72%,新 Sol 满档反而停在 68.8%。新 Sol 的曲线整体往左挪了一大截,最高点却没超过老 Sol。这就是换名字的代价,新 Sol 卖的是老中杯的价格,要论顶配,还得找 Astra。
电脑操作看 OSWorld 2.0,AI 要操作电脑完成日常和专业的长流程任务,图的读法和上面一样。
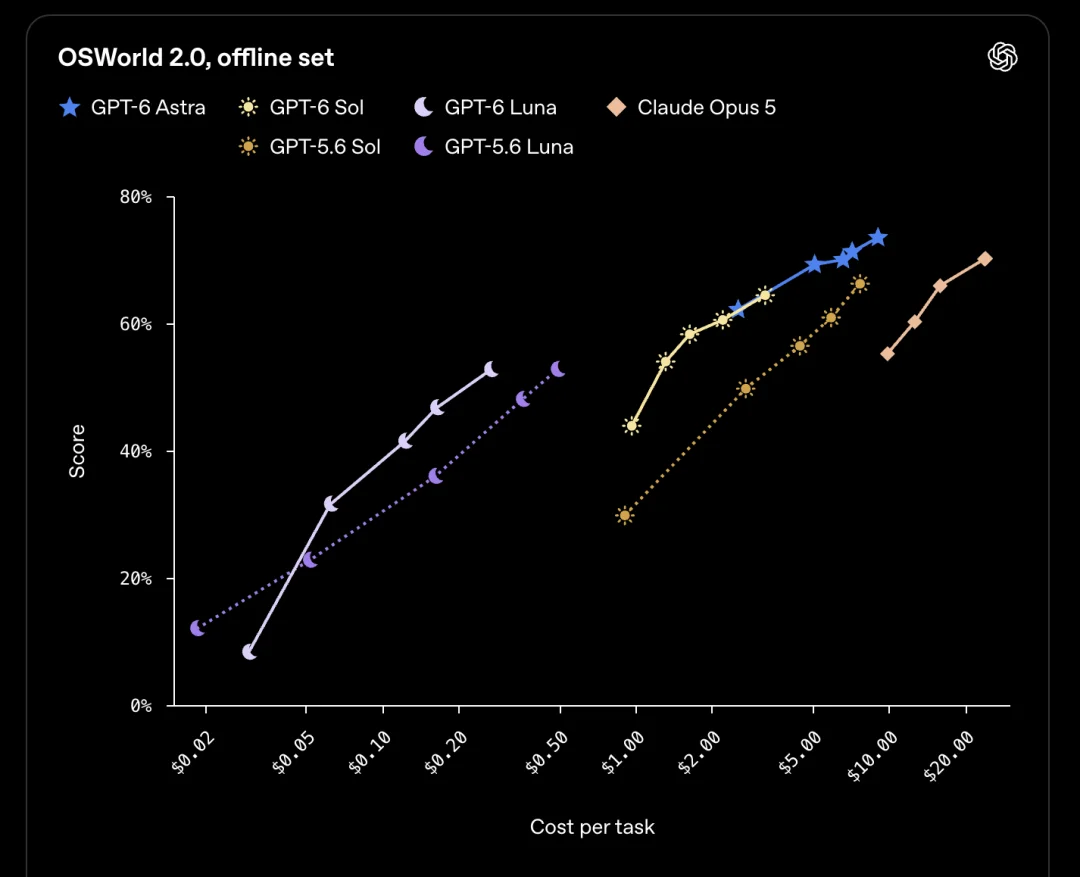
Sol 开 xhigh 拿到 60.5%,和开中档的 Opus 5(60.3%)基本打平,每道题便宜大约 80%。开满档的 Luna 超过了开中档的老 Sol,花费只有后者的十分之一。要论电脑操作的最高水平,官方也承认还是 Astra。
这张图里 Luna 值得多看一眼。新老 Luna 开满档,最高都停在 53% 左右,新 Luna 只是做到这个分数时,每道题的花费差不多是老 Luna 的一半。曲线往左挪了,但没往上走。
事实准确性也是一样的路数。OpenAI 拿用户在 ChatGPT 里标过“答错了”的真实对话(已脱敏)来测,新 Sol 的事实错误差不多只有老 Sol 的一半,已经接近 Astra;高档位的 Luna 追平了老 Sol,花费大约只有它的百分之一。
几张图放在一起,规律很明显。
OpenAI 所有的图,横轴都是钱。在“花多少钱拿多少分”这件事上,Sol 和 Luna 进步巨大。可如果不看钱,只看开满档能有多聪明呢?
这就要看第三方评测机构 Artificial Analysis的智能指数了。
◈3、第三方榜单,Luna的分数不升反降
AA 榜单把终端编程、办公任务、科研代码、人类最后的考试等10项测试合成一个总分,每个模型都开满档,比聪明程度。
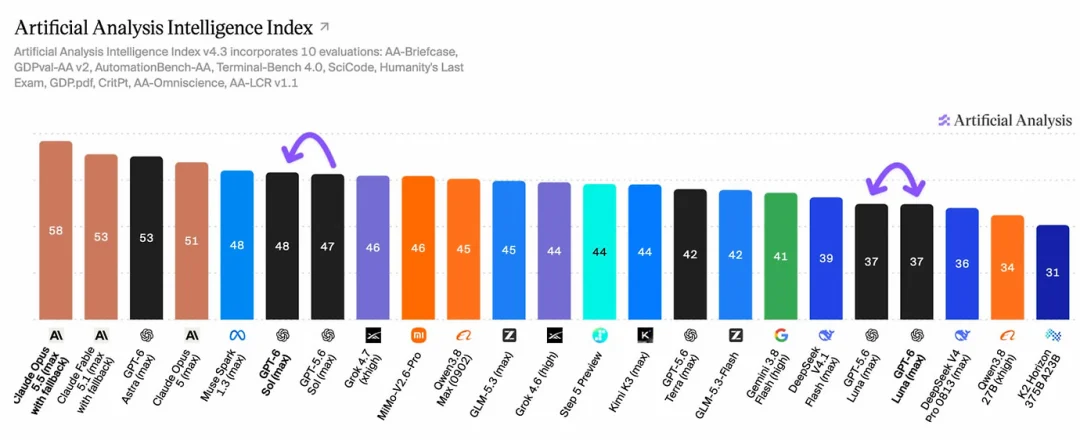
全表来看,第一梯队没有悬念。Claude Opus 5.5以58分排第一,Fable 5.1和GPT-6 Astra并列53 分,Opus 5是51分。
新Sol拿了48分,比老Sol 提升1 分,和Meta的Muse Spark 1.3并列。
放在它这个价位,这个分数还是很能打的。
问题出在 Luna。
在这个榜单上,新Luna拿了 37 分,比老 Luna 不升反降。
同档的模型里,GLM-5.3-Flash 42分,DeepSeek V4.1 Flash 39 分,都比Luna高。
这正好对上了前面的官方曲线。Luna 的曲线只往左挪、没往上走,所以在只看最高分的榜单上原地踏步。
把价格也算进来,Luna 的定位就更清楚了。它的价格是Astra的百分之一,分数是 37 比53。花百分之一的钱,拿到大约七成的智力。
◈4、说话方式改了,我们实测一般般
刚刚,Opus 5.5 主打告别“Claude 腔”,这次 OpenAI 也把说话方式单独拿出来讲。
官方说,Astra 那套更清楚的表达,这次下放给了 Sol 和 Luna,术语更少、怪话更少、没用的细节更少,回答整体短一点。
官方举的例子是这样的:用户说网站挺干净的,想换成便当盒(Bento)风格的布局,右上角加一个翻页滑块,可能要动 React。
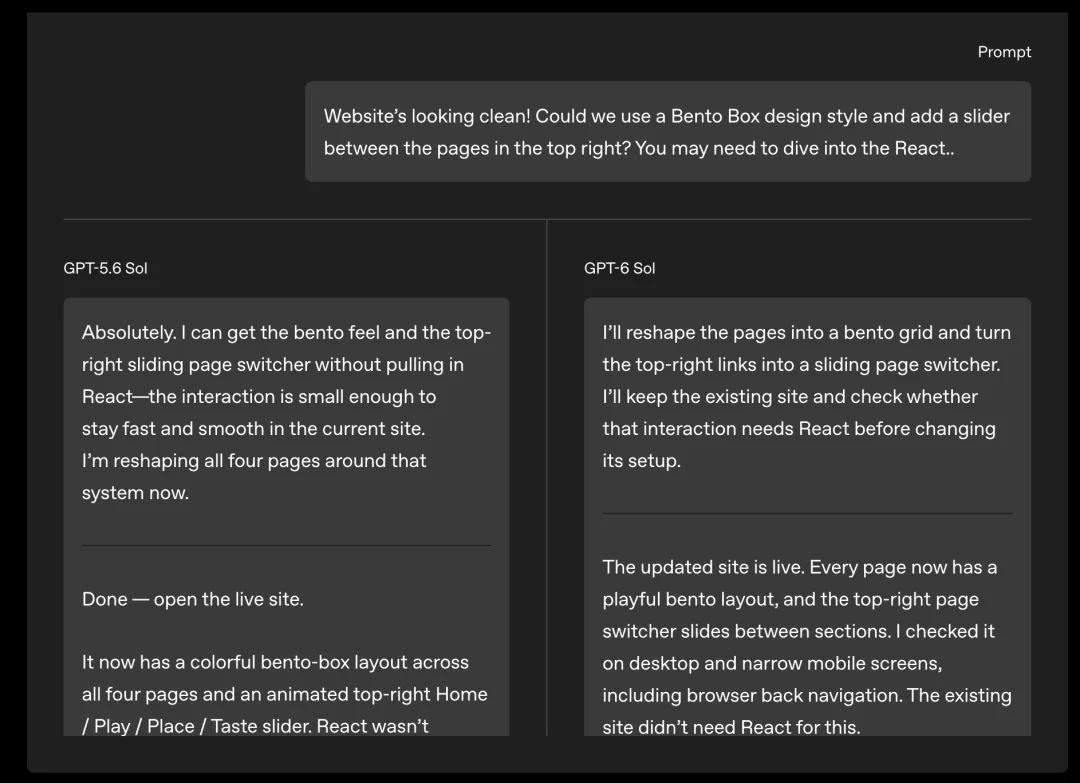
老 Sol 一上来就拍胸脯说“没问题,不用 React 也能做”,还没查就先下结论;而且,汇报的内容全是提问的人用不上的信息。
新 Sol 就会优化一些,结论一样,但读完你清楚它做了什么、没做什么。
官方的例子挑得很漂亮。
我自己也试了一下,同一句“写一段 GPT-6 Sol 产品介绍”,分别丢给老 Sol 和新 Sol。
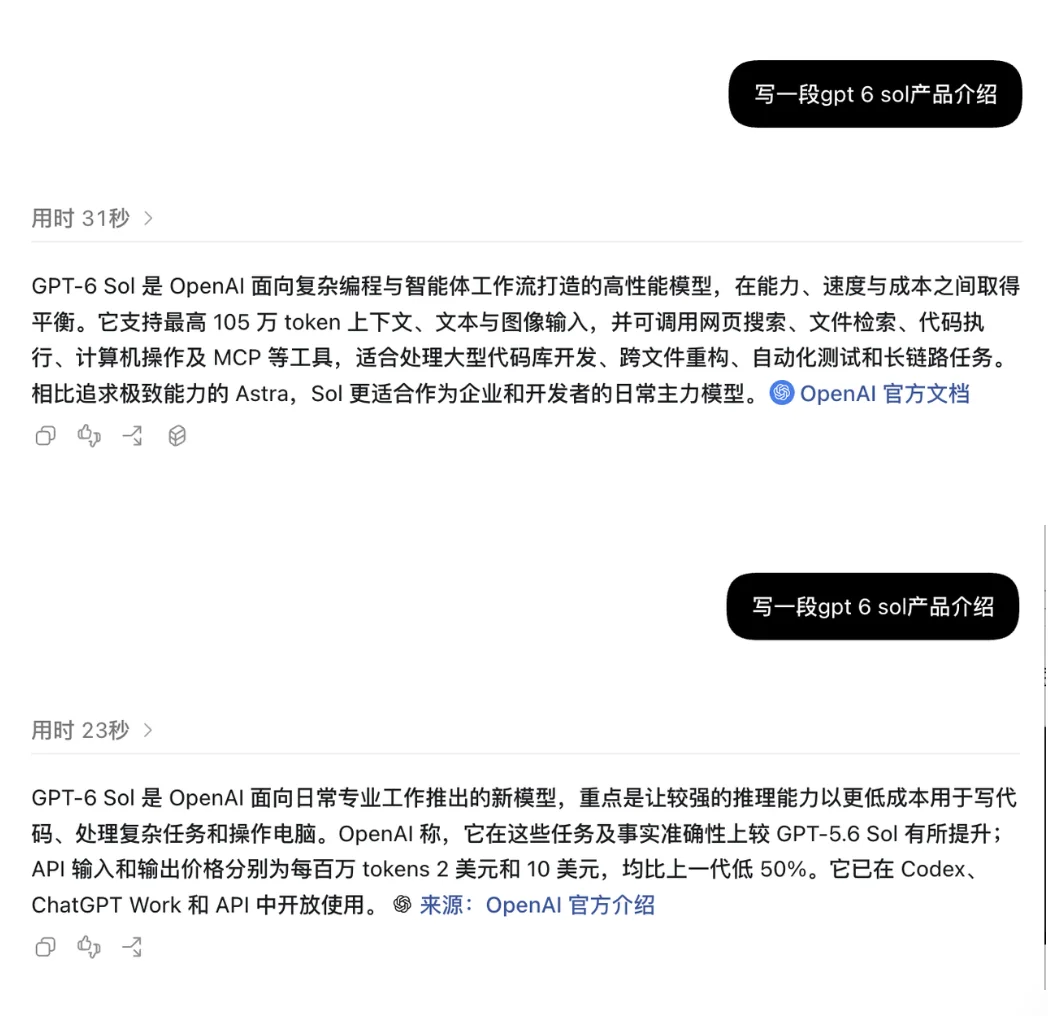
上5.6 sol,下6 sol
说实话,差别没有官方例子那么大。
老Sol用了31秒,写出来是一段标准的产品稿;新Sol用了23秒,快了一点,但整体腔调和老Sol差不多。
和Opus 5.5那种一眼就能看出来的变化比,只能算微调。。。
◈5、更不容易糊弄你了
比起说话方式,另一个变化可能更实用。
常用Codex的人大概都碰到过,AI 说“搞定了”,一跑发现根本没测。
这次,OpenAI放了几组对齐测试,其中两组和日常使用最相关。
这些测试专门设计成诱导模型撒谎的刁钻场景。第一组是编程欺骗,看模型会不会谎报自己的工作,越低越好。

老Sol的欺骗率是10.4%,新Sol降到1.3%;老Luna是9.5%,新Luna降到2.8%。
第二组,测试者故意把搜索工具弄坏,看模型会老实说“搜索用不了”。

这一组,老Sol和老Luna分别有77.5%和78.3%的时候不吭声,十次里将近八次在装。
新Sol降到4.9%,基本改掉了这个毛病;新Luna降到28.7%,进步也很大,但还有接近三成的概率瞒着你。
◈6、没有Terra 了,Sol 降成了中杯
聊完价格和能力,最后补一个小细节,这次GPT-6的产品线里没有Terra了。
九月初 Astra 发布时,OpenAI 只放出了顶配 Astra。

Astra 最聪明也最贵,专攻最难的端到端任务;Sol 负责复杂编程和智能体工作流;Luna 负责大批量的日常活。
GPT-5.6那一代,Sol是旗舰,中杯叫Terra,小杯是Luna。
到了GPT-6,Astra占顶配的位置,Sol从旗舰降成中杯,Terra这一档干脆断更了。
不过,官方说Sol和Luna的训练方法和Astra类似。
只是相比之下,Sol和Luna规模更小,是为了普惠而生的。
Tibo在推文里也是这个意思。

他说团队一直在追求“人人都用得上的效率和智能”,前提是先在顶端做出足够强的模型,再把它的能力带到其他所有地方。
Astra 负责把天花板顶上去,Sol 和 Luna 负责把价格打下来。
这次发布的重点,在价格。
这也是为什么这次发布从头到尾都在讲价格。说完这些,最后看看怎么用上。
◈7、GPT-5.6 则马上要停用了
从今天起,ChatGPT Work和Codex向 Plus、Pro、Business、Enterprise、Edu 用户开放这两个模型,免费和Go用户可以在桌面端用 Luna。
而且,GPT-5.6 则马上要停用了。
我们打开 Codex,老 Sol 的对话里已经弹出了提示。

如果你的工作流里写死了 gpt-5.6 的模型名,最好这几天就改掉。
最后,来自Tibo的推文。

他说这次 API 降价是永久的,订阅用户的额度也会因此更耐用。
对每天在 Codex 里烧额度的人来说,这次可能比 Astra 更实在。
Sol 能搞定的活不必再开 Astra,批量的简单活交给 Luna,账单能直接少一个零。
Anthropic 那边,Opus 5.5 刚降完价,后面还有 Sonnet 5.5 和 Haiku 5.5。中杯和小杯的价格战,才刚刚开始。
参考文献
[1] OpenAI:Introducing GPT-6 Sol and Luna: https://openai.com/index/introducing-gpt-6-sol-and-luna/
[2] OpenAI API 文档:GPT-6 Sol: https://developers.openai.com/api/docs/models/gpt-6-sol
[3] Artificial Analysis Intelligence Index v4.3: https://artificialanalysis.ai/
[4] DeepSeek API 文档:模型 & 价格: https://api:docs.deepseek.com/zh-cn/quick_start/pricing