阅读预计 8 分钟
前几天,我们围观了一场可能是科技圈最贵的直播。
小米把还没训练完的 MiMo-V2.6 直接挂到了网上。没有主播,屏幕上只有不断往上涨的 Token,以及一刻不停往外烧的钱。
现在,它终于练完了。
昨天,小米正式推出 MiMo-V2.6-Flash、MiMo-V2.6-Pro,以及 Pro 的 UltraSpeed 版本。
紧接着,小米公布了最新 RL Dashboard 的终局数据:
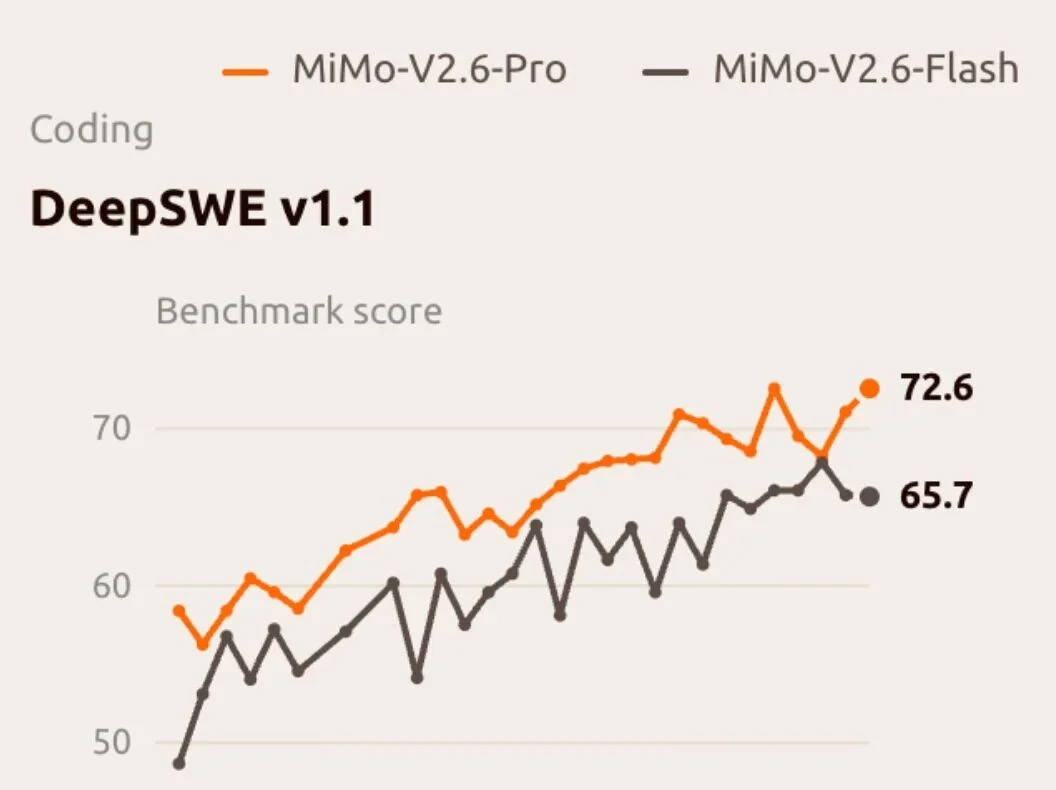
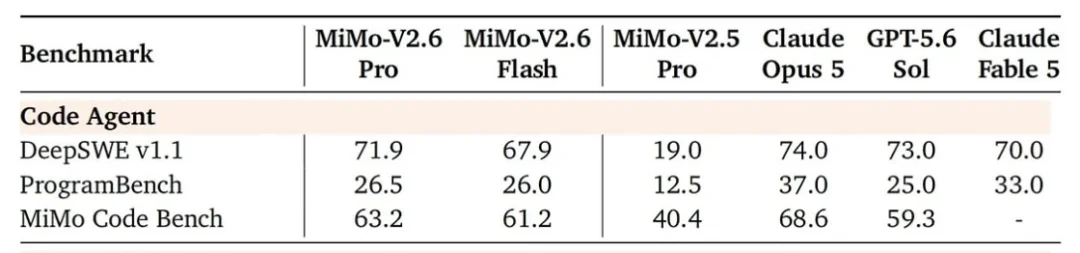
经过曲折的过程,pro 版本来到了72.6分。DeepSWE v1.1 的跑分已超 Fable 5。
随后,Artificial Analysis Intelligence Index(AA综合智能指数)榜单公布:
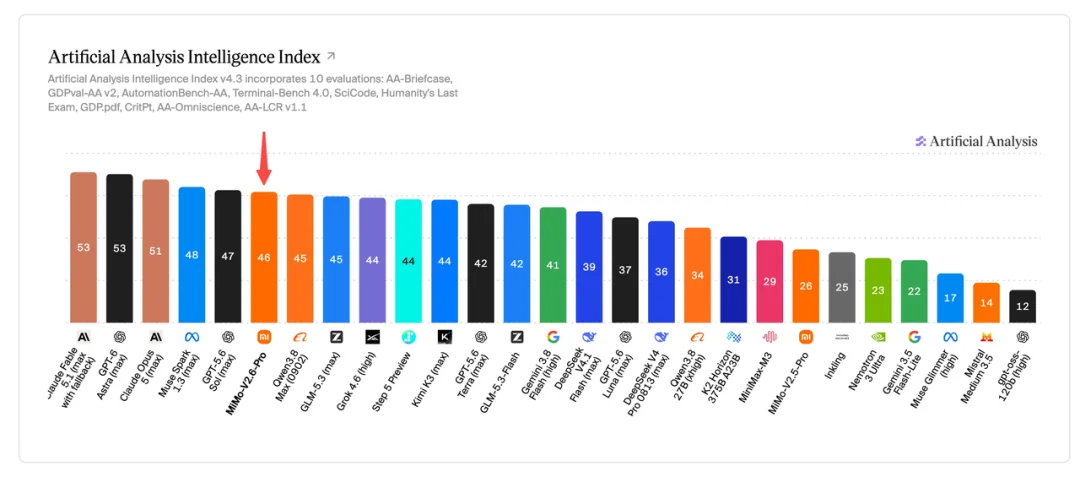
MiMo-V2.6-Pro 取得 46 分,超过Kimi K3 和 Qwen3.8 Max,成为当前最强的开源模型。
RAIR Lab创始人、《从零构建大模型》作者Sebastian Raschka读完技术报告后评价:
“simply” the best (for now)。 意思是 MiMo 眼下在开源权重模型里排第一,而它的架构其实很简单。
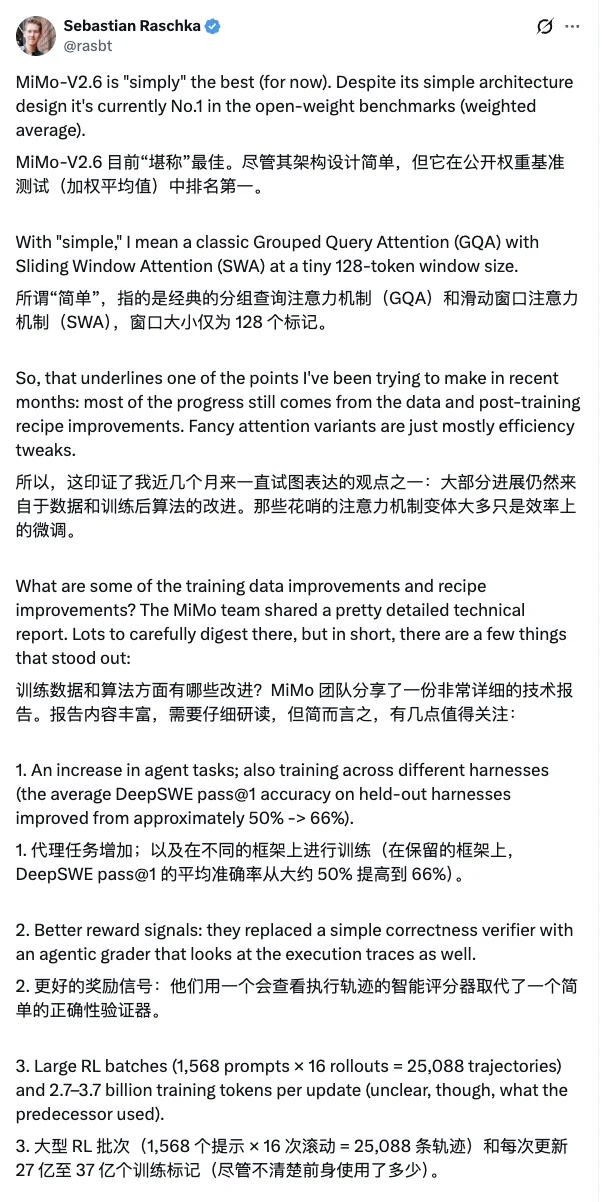
MiMo-V2.6 的架构是经典的分组查询注意力(GQA),加上窗口只有128个Token的滑动窗口注意力(SWA)。
Raschka 认为,这说明模型的进步主要来自数据和后训练,花样繁多的注意力变体大多只是效率优化。
而就是这些效率优化,能在训练和推理上省下几百万美元。
Menlo Ventures的投资人也在Deedy上手玩了一圈,直接给了评价:「pretty impressed」。
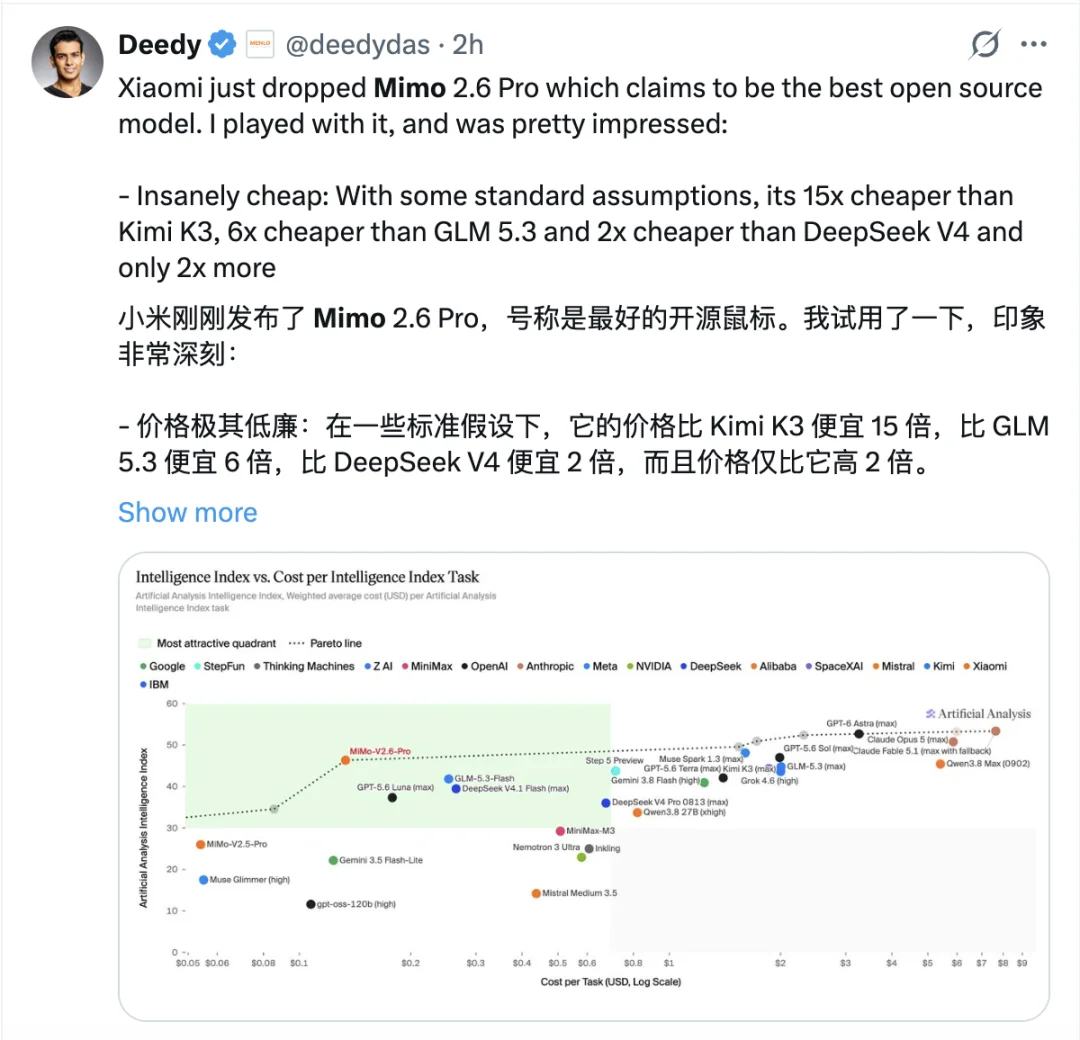
照他的计算,MiMo-V2.6-Pro的使用成本只有Kimi K3的约十五分之一、GLM 5.3的约六分之一、DeepSeek V4的约一半。
在最新的Artificial Analysis 智能指数 × 单任务成本图里,MiMo-V2.6-Pro 正好落在图左上角的最优象限。
是同等价格和同等智能水平之内的最优选。
跑分已经看到了,但毕竟 Benchmark 不是产品。
前几天我们看着它的训练过程,现在模型出来了,今天进入实测。
◈一、复杂Coding
◽孪生素数星系:千万级计算与渲染并发
我要求:
计算 1000 万以内的“孪生素数”(相差 2 的素数对,如 3和5、11和13),并用 Canvas/WebGL 摆成一条阿基米德螺线的星空;还要支持缩放、点选、区间过滤和视角切换。
这是个很复杂的任务了。因为数据量顶上去之后,计算、渲染、搜索,任何一件掉链子,整个页面就废了。
最终,MiMo 顶住压力输出了界面,整个惊艳到我了。
算法、后台线程、渲染、交互,一次成型。我实际复核了一下,它交付的实打实都是真正的孪生素数。
而且摆放的位置也没问题,点星空里一颗双星,右侧详情卡立刻换成这一对的数字,底部的直方图也会跟着跳转
◽复杂 3D 场景建模:Earth Observatory
素数算对了,应用跑通了。接下来我想看它接驳真实世界数据的情况。
我要求 MiMo:
抓取 USGS(美国地质调查局)等真实 API 的地震数据,做一个带脉冲动画的 3D 实时地震数据观测台。把最近7天发生的地震展示在地图上,地震点按震级分三档颜色,M≥6 红色脉冲、5 到 6 级橙色。
这是个设计前后端结合的任务,需要调用API来解决。
MiMo 交付的是一个完整的地球模型,震点星星点点标在上面,带位置和时间。
点开任意一个震点,详情页面就会出现在眼前。
我要的「按震级改变大小和颜色,带脉冲动画」,都对上了。
点哪都有反应,数据链做得非常完整。
下一个维度。我想看看它的审美水平。
◈二、审美水平
模型的审美水平非常影响大家使用它的心情,毕竟,如果一个模型输出的内容非常丑,即使做的内容到位我也不一定选择它。
◽PPT :World in Motion
审美水平影响最显著的场景就是PPT了。
但做PPT的难点其实不在排版。现在,很多模型都能做出炫酷的PPT,但是一看内容常常是假大空。
因为除了美观,PPT还有一个最重要的功能是信息的压缩,做出来的界面每一页得有一个判断,而这个判断必须是真数据算出来的。
最终,MiMo输出了一份9页PPTX,在WPS里能直接编辑,标题叫「人类的四条生命曲线——人口、年龄、寿命与收入」。
风格简约大气,数据处理也很扎实,下了很多判断。
PPT的每页标题都是一个判断:
「尺度不同,方向大体同向」「寿命变长 ≠ 总负担变轻」「收入增长不保证寿命同步改善」,读完标题就读完了结论。
而且,界面上深蓝、米白、砖红三色统一,每页页脚都挂着数据源。
完成度非常高,像一个资深数据分析师的手笔。
◽高质量 Design
除了PPT,Design 界面的能力也很重要。
我交给MiMo一份大都会博物馆的公开藏品API,让它从里面挑四五十件公有领域的作品,做一个线上展。
题目叫「Human Visual Memory」,人类的视觉记忆。
审美这种题,最容易做成「好看但空」。图片墙谁都能堆,难的是分页、缓存、懒加载这些底层活儿别拖慢页面。
版权信息要一件一件挂对,还要有一点策展的味道。

经过一番设计,MiMo最终交付了结果。
视觉效果非常惊艳。整站米白底、中间瀑布流图片墙、右侧详情抽屉做成了博物馆展签的样子。
整体的视觉效果很舒适,非常贴合视觉记忆的主题。
接着,我不满足于此。
为了更贴切「Human Visual Memory」的主题,我又让MiMo做了一个功能:在页面中展示一张「今日记忆卡」。
他会从网站随机挑三件作品,让你记住3张目标,8秒后,让你从整个网站里找回这三张图。
大概是这样的:

我实际上手操作了一下,体验非常丝滑,而且整体的视觉效果也很不错。
◈三、多模态
除了审美能力,在实际模型使用中,多模态能力也至关重要。
为了测试多模态能力,我想让MiMo帮我剪个视频。
我先给它一段参考视频,这是一条59秒的老片子,1968到2016年各国 GDP 的动态排名。
视频源:苏州公安
我要求MiMo:
看懂这条视频在讲什么、怎么讲的。想自己做一条类似的看的人口预期寿命的数据短片。
它得先看明白视频里的「叙事套路」,然后自己去找数据、算数据、做动画,把这套路子重新走一遍。
最终,MiMo交付的效果如下:
从1960一路跑到2023。每个数据柱上都有国旗和当年的岁数,随年份滚动换。视频下面还会弹出字幕,实时分析数据的特征:
-
1973年,「日本登顶预期寿命第一」; -
1980年,「天花被根除,人类消灭一种传染病」; -
2020年,「新冠疫情,整体回落」。
而且它分析的很准确了。
等于看懂了原有视频的叙事,又精准拿走了叙事套路。
只是数据是自己找的,判断是自己下的。
看来,之后想学什么视频展示的手法,直接丢给MiMo就好了呀。
原生多模态的意义也在这里。你给模型看一个东西,它能把「这个东西为什么好」学走,再用到别的地方。
◈四、速度与成本对比
case测完,我们来算个账。
MiMo-V2.6 这次最夸张的地方,可能还不是能力,而是价格。

MiMo-V2.6-Pro的常规输入价格是3元/百万 Token,输出6元/百万 Token;Flash 更低,输入、输出分别只有1元和2元/百万 Token。
如果输入命中缓存,Pro 更是低到0.025 元/百万 Token。
单看Token单价还不够直观。
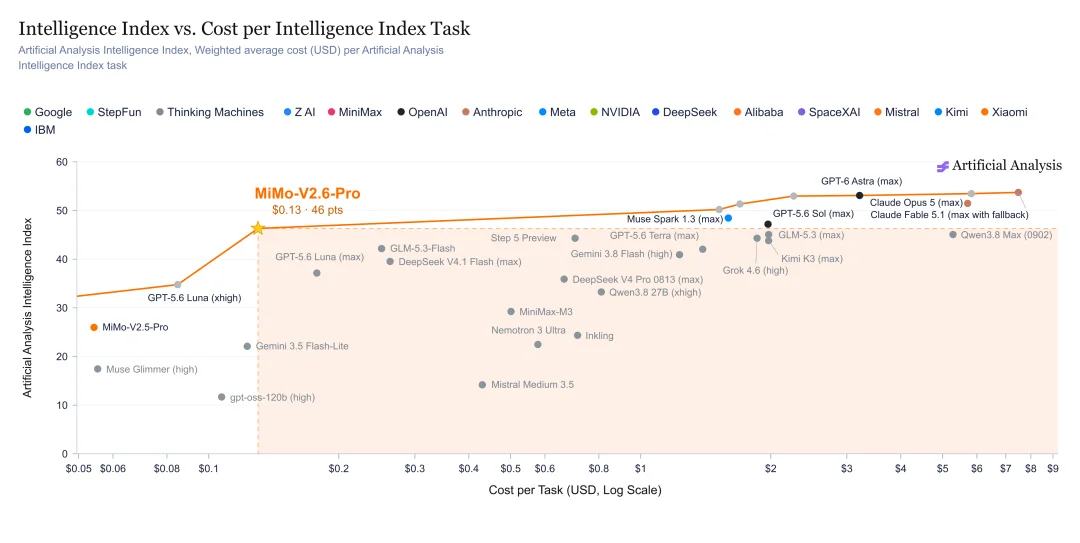
下面这张图来自第三方评测机构Artificial Analysis。

它算的是跑完 AA 那套评测,让不同模型跑同一套 Intelligence Index,然后按照各家 API 的实际价格,把平均做完一道题要花多少钱算出来。
结果有点夸张。
MiMo-V2.6-Pro 平均做完一道题,只要0.13美元。
相比之下,GPT-6 Astra是3.26美元,Claude Fable 5.1 是7.63美元。
MiMo 做一道题的成本,大约只有 GPT-6 Astra 的二十五分之一、Claude Fable 5.1 的五十九分之一。
把能力和成本放到一张图里,它的优势更加明显。

横轴是每道题的成本,纵轴是智能指数。越往左越便宜,越往上越聪明。
和MiMo-V2.6同一天发布的Grok 4.7,智能指数也是46分,但开高推理做一道题要2.73美元,开到极高推理要3.74美元,分别是MiMo-V2.6-Pro的21倍和29倍。
MiMo-V2.6-Pro 正好落在了帕累托前沿上。
意思是:
在 0.13 美元这个价位,没有比MiMo-V2.6-Pro聪明的;在46 分这个智能水平也没有比它便宜的。
不只单纯把价格打下来,能力和价格也一起往左上角推了一截。
速度这边,小米还单独做了一个MiMo-V2.6-Pro-UltraSpeed。官方称,在保持同等模型质量的前提下,它的输出速度最高可以做到普通 Pro 的20倍。
代价是,UltraSpeed的API 单价大约是普通Pro的10倍。
◈五、从大规模RL,迈向RSI
如此强大的性价比,小米是咋做到的?
答案在训练阶段。
MiMo 负责人罗福莉发帖称,MiMo-V2.6 很可能是迄今为止任何开源模型团队做过的、按算力算最大的一次单轮 RL。

算力极度紧缺的年代,MiMo 仍然选择把几十人的团队押在这一件事上。
她还提到,这轮 RL 的工程难度超过了 DeepSeek-R1。
MiMo团队披露,这轮 RL 不到6天,Flash和Pro都跑了30个 Step、约75万条 trajectory。
其中 Flash 的 RL 成本大约85万美元,Pro 更是烧掉了262万美元。
它这次最核心的思路是:把 RL 做大。

以前很多模型做强化学习,更像是分科补习。代码单独练代码,Agent 单独练 Agent,视觉再开一套训练。
MiMo-V2.6 这次把 Coding、通用 Agent、视觉和网络安全任务混在同一轮 RL里训练,小米把这套方法叫 You Only RL Once。
不同任务、不同执行环境被混进同一个 batch,希望一种任务里学到的策略,能迁移到另一种任务上。
而且,小米不只是给模型更多题做,还开始给判卷 增加算力。
MiMo-V2.6 又加了一层 Groupwise Agentic Grading。
它会把多条解法放在一起比较过程质量,再把更多奖励给更短、更好的路径。
官方技术报告称,这套机制会把训练信号推向更短的执行路径和更少的任务 Token。
前几天,我们盯着直播间里上涨的数字,看小米几百万美元地往 RL 里烧。

几天之后,这些钱最后变成了 3 元/百万 Token 的输入价格、6 元/百万 Token 的输出价格,以及一个已经能认真拿来干活的模型。
小米这场最贵直播,到这里算是播完了。
接下来,轮到我们开始烧 Token 了。