阅读预计 4 分钟
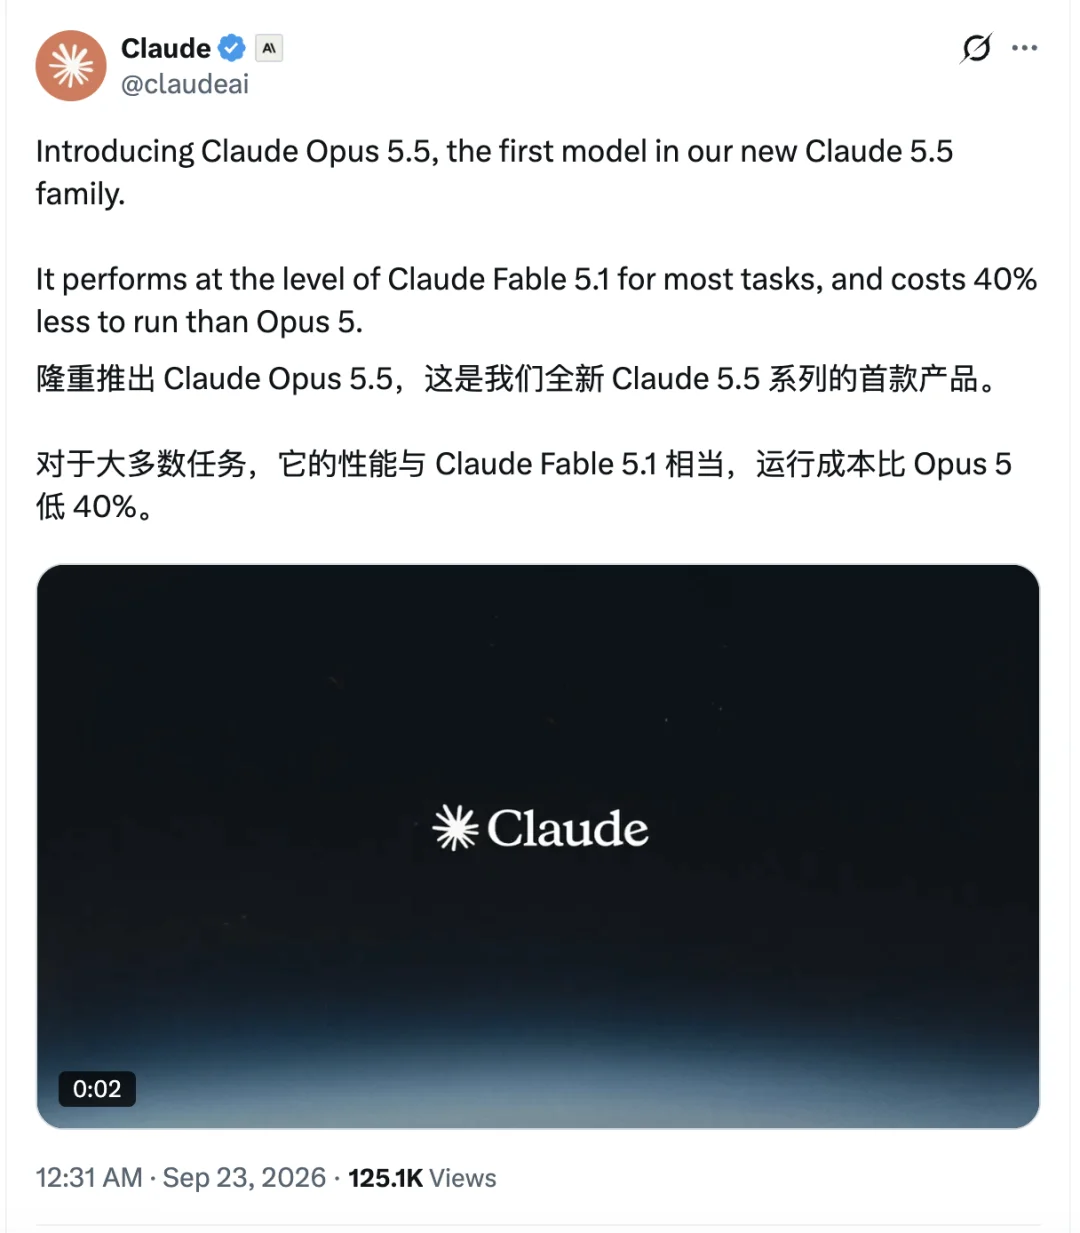
刚刚,Anthropic发布Claude Opus 5.5,这是新的Claude 5.5系列里的第一个模型。
能力与 Claude Fable 5.1 打平的同时。
Opus 5.5 的运行成本比Fable,便宜60%,比Opus 5低40%!!
最重要的一点,Claude这次终于终于学会说人话了。
这可能是近半年来,第一个把人话说的这么好的模型了!!(后面我们细讲)
还是先看成绩单。
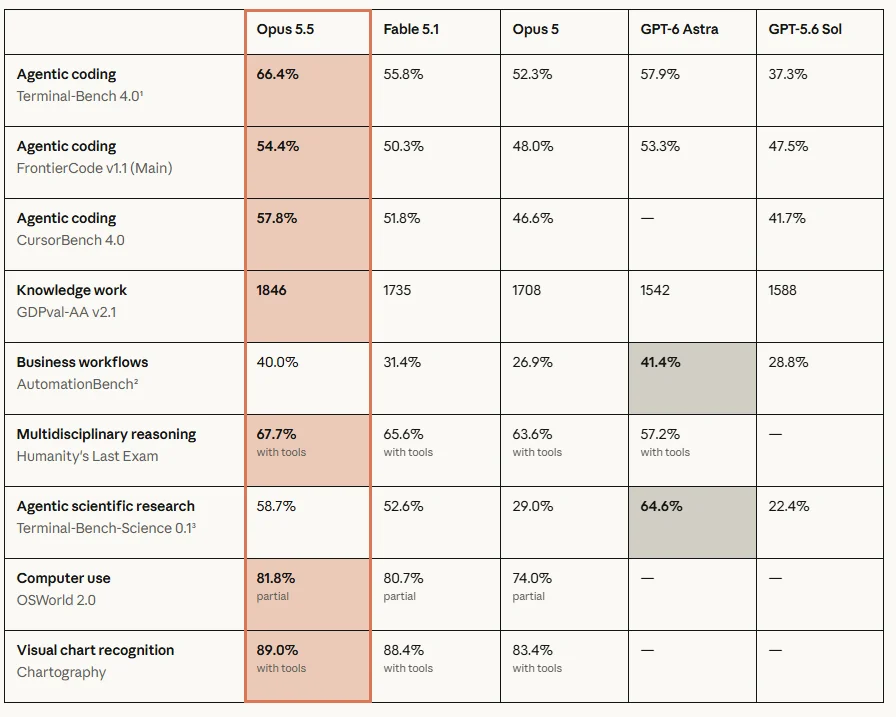
Terminal-Bench 4.0(真实代码能力)。Opus 5.5拿了 66.4%,比 Fable 5.1 的 55.8% 高了10个多点,也压过 GPT-6 Astra 的 57.9%。这是整张表里拉开差距最大的一项。
CursorBench 4.0 考的是在 Cursor 里做真实的长流程软件工程,Opus 5.5 是 57.8%,Fable 5.1 是 51.8%,Opus 5 只有 46.6%。
写代码之外,办公类任务也有明显进步。
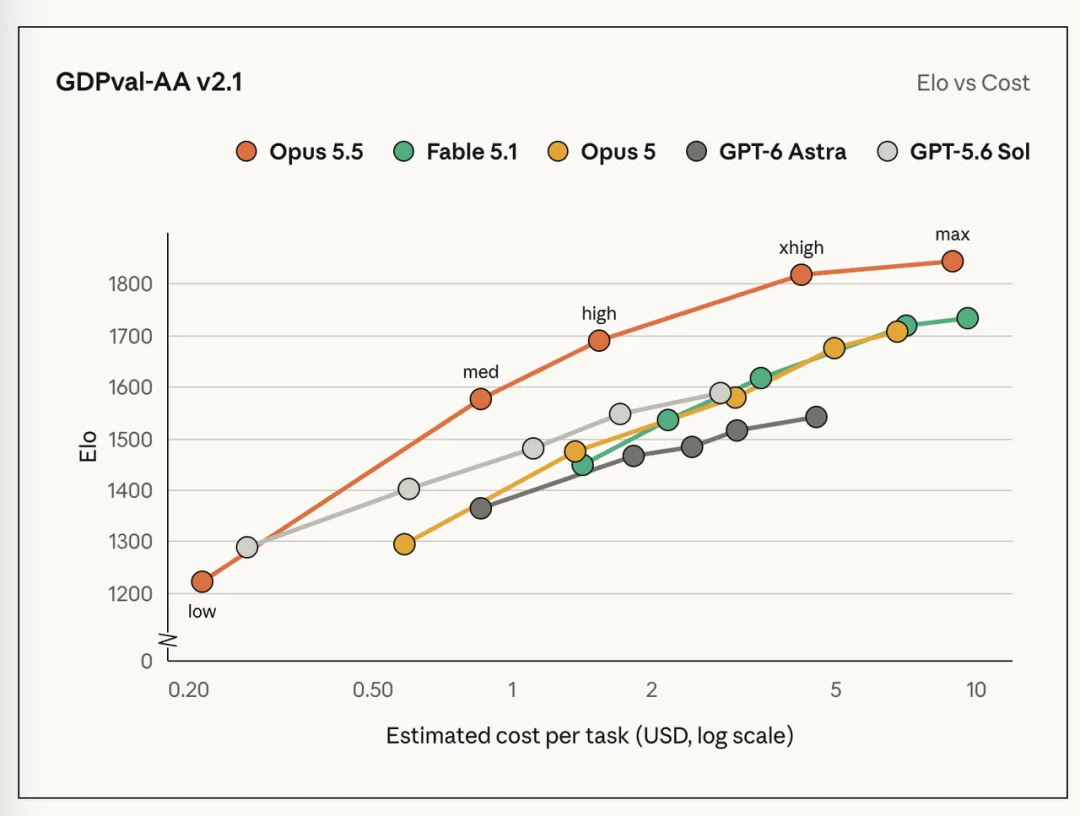
GDPval-AA v2.1 是模拟律师、分析师、工程师这类职业的真实工作任务,Opus 5.5 打出1846分,远超 Fable 5.1的1735,GPT-6 Astra 的1542。
电脑操作(OSWorld 2.0)81.8%、图表识别(Chartography)89.0%、人类最后的考试(HLE)67.7%,这几项它都比 Fable 5.1 略高一点,基本属于打平。
我实测了电脑操作能力,真的非常、极其丝滑。远胜GPT-6 Astra。。
当然,也不是每项都第一:
-
AutomationBench
(企业自动化流程)上,GPT-6 Astra 41.4%,比 Opus 5.5 的 40.0% 略高; -
Terminal-Bench-Science
(科研类终端任务)上,Astra 64.6%,Opus 5.5 58.7%,差距更明显一些。
简单说,写代码、办公、操作电脑是Opus 5.5 的强项。
科研和企业自动化这两块,GPT-6 Astra还占优势。
再说个我认为最显著的变化。这次,新模型终于没有“Claude 腔”了!
◈终于不“Claude 腔”了!
经常用 Claude 的人应该有感觉:回答偏长,重点藏在中间,还喜欢堆术语。
海外网友甚至专门给这个起了个名字,叫“Claudish”。
这次官方正面回应了:Opus 5.5 会把最重要的信息放在最前面,少用术语,更严格地遵守你给的写作要求。
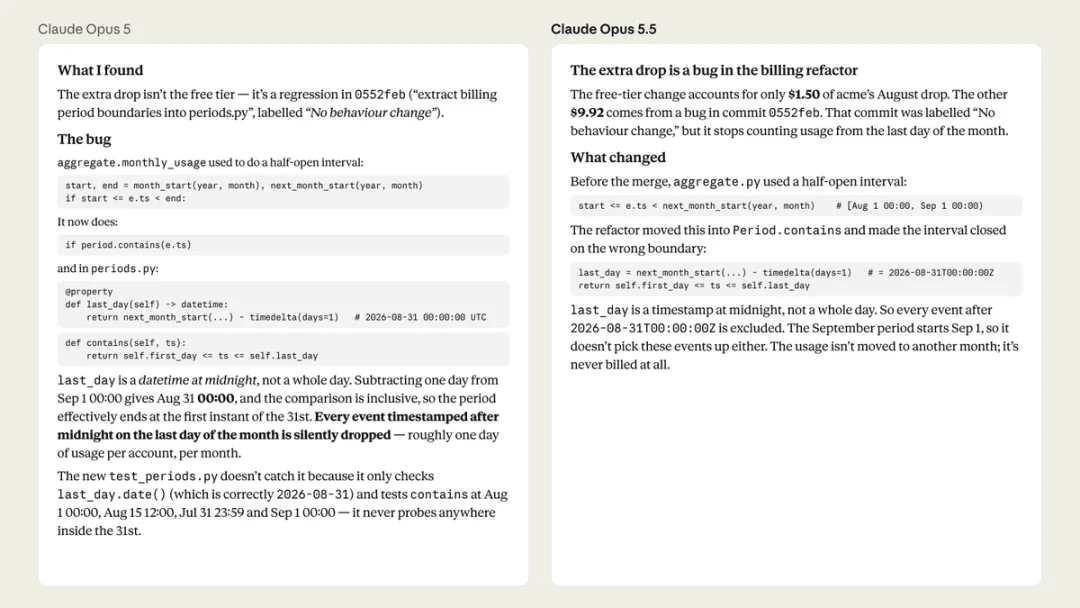
如图,左边是Opus 5,右边是 Opus 5.5,同一个排查 bug 的问题,右边明显短了不少,也好读了很多。
官方的例子是英文的,我们也用中文试了一下。同一句“写一段 Opus 5 产品介绍”,分别交给 Opus 5(High 档)和 Opus 5.5(Medium 档)。
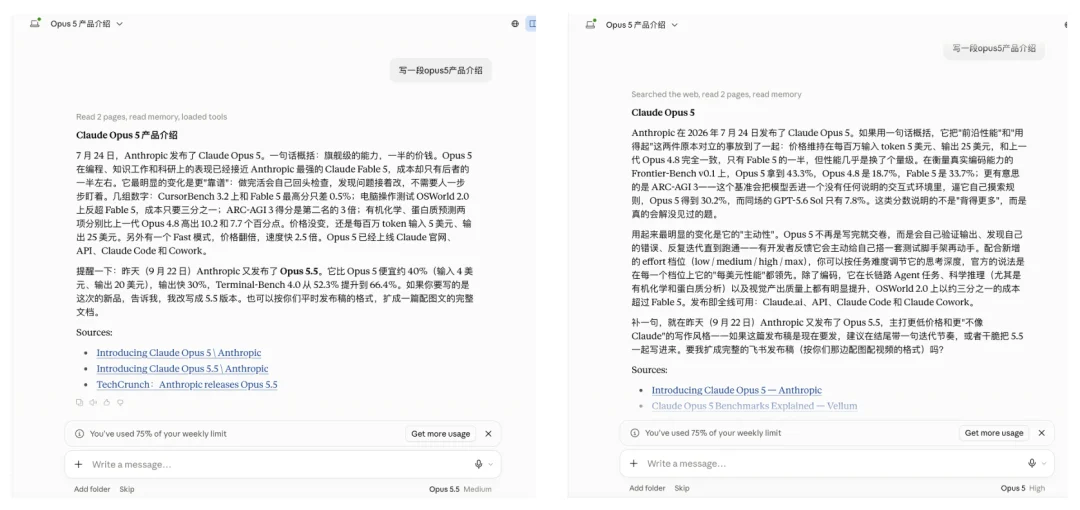
左Opus 5.5 ,右Opus 5的回答
Opus 5 写了三大段,全文一大堆引号,奇怪的句式,啰里八嗦的。。
反观Opus 5.5,开头就是一句:
“旗舰级的能力,一半的价钱。”
接着直接列数字,两段写完,读起来轻松很多。
而且 Opus 5.5 用的还是更低的 Medium 档,比 Opus 5 少思考了一档,写出来的反而更清楚。
◈中档就够用了
只看最高分,其实不太能说明日常用起来怎么样。
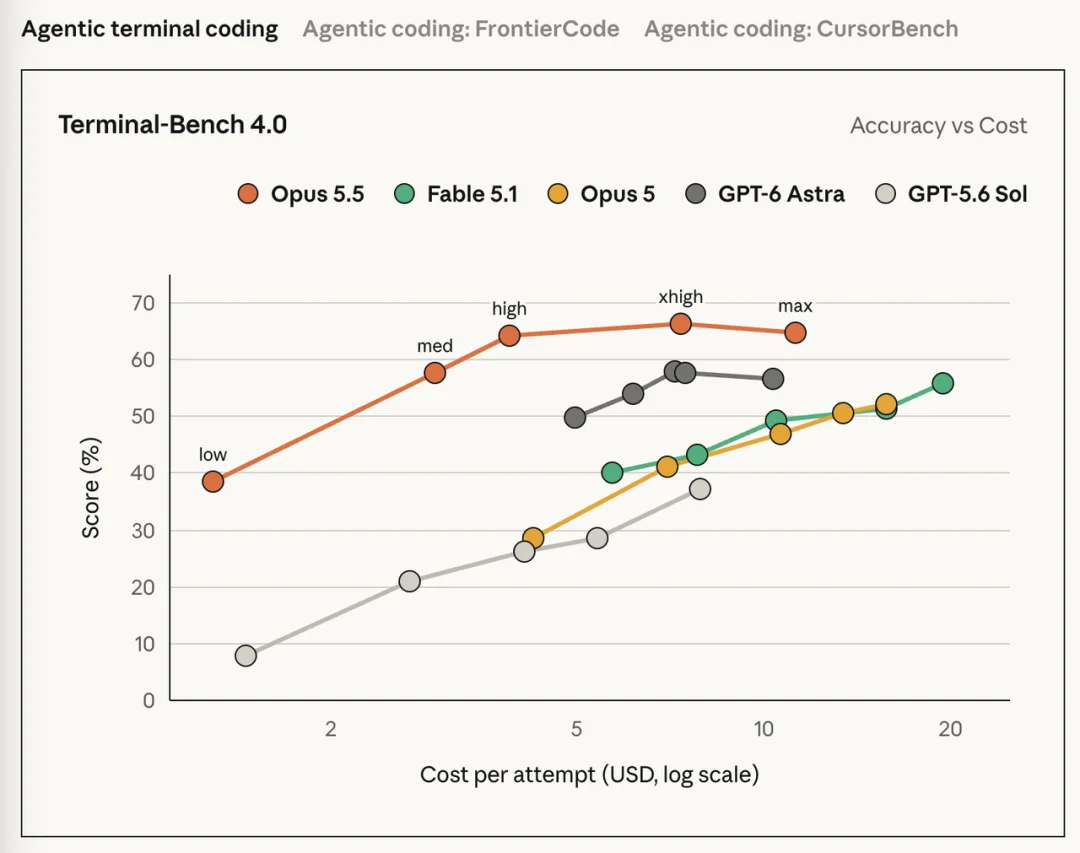
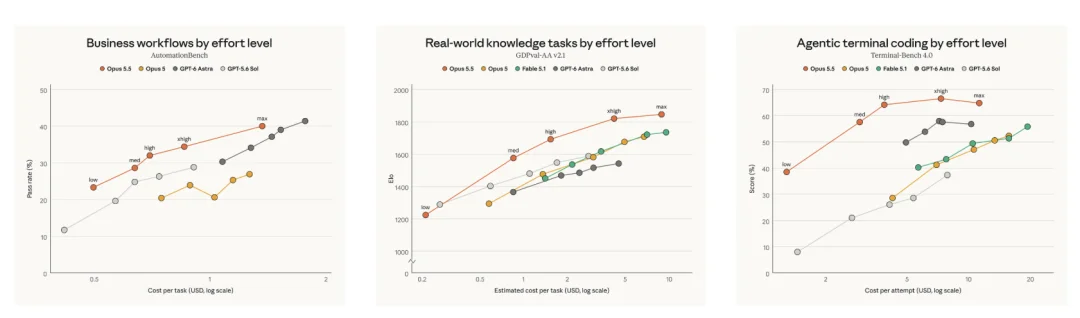
这次官方还放了一组曲线,画出了每个模型在不同思考档位(effort)下,花多少钱、能拿多少分。
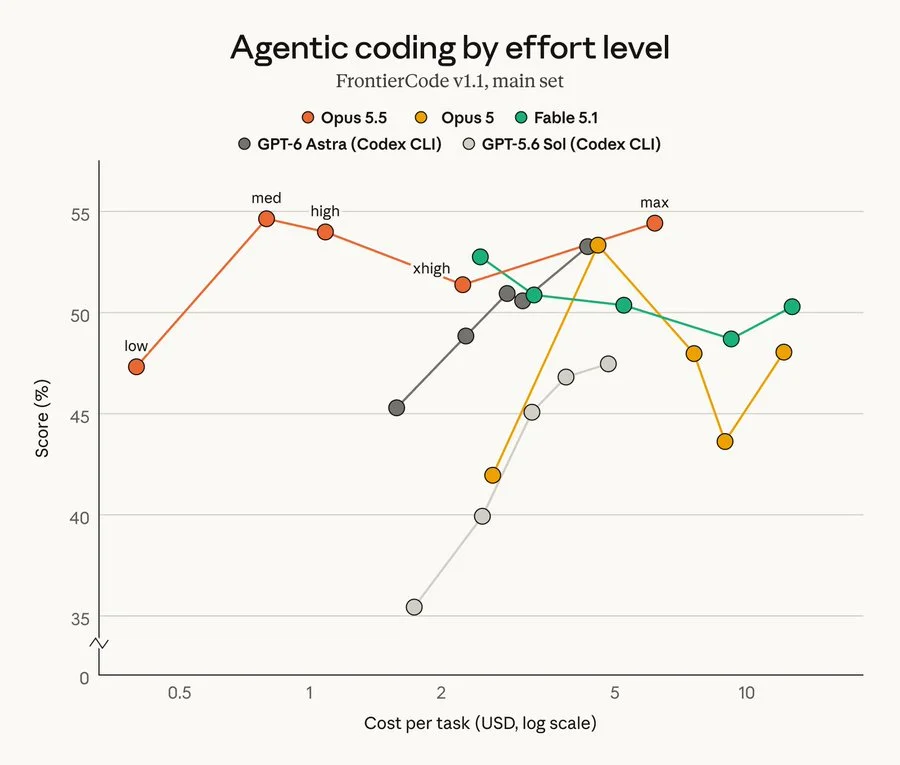
横轴是每道题花的钱,纵轴是分数。橙色那条是 Opus 5.5。
能看出来,Opus 5.5 开到中档(med),分数就已经超过了 Opus 5 和 Fable 5.1 开到最高档的成绩,每道题的花费却只有它们的几分之一。
再往上开到 high、xhigh,分数还会涨一点,但涨幅不大。
所以日常用的话,Opus 5.5中档就是性价比最高的位置!!
另外三张图的趋势差不多:同样的分数,Opus 5.5 花得更少;同样的钱,Opus 5.5 分数更高。
第三方评测机构 Artificial Analysis 也跑了一遍,结论差不多。
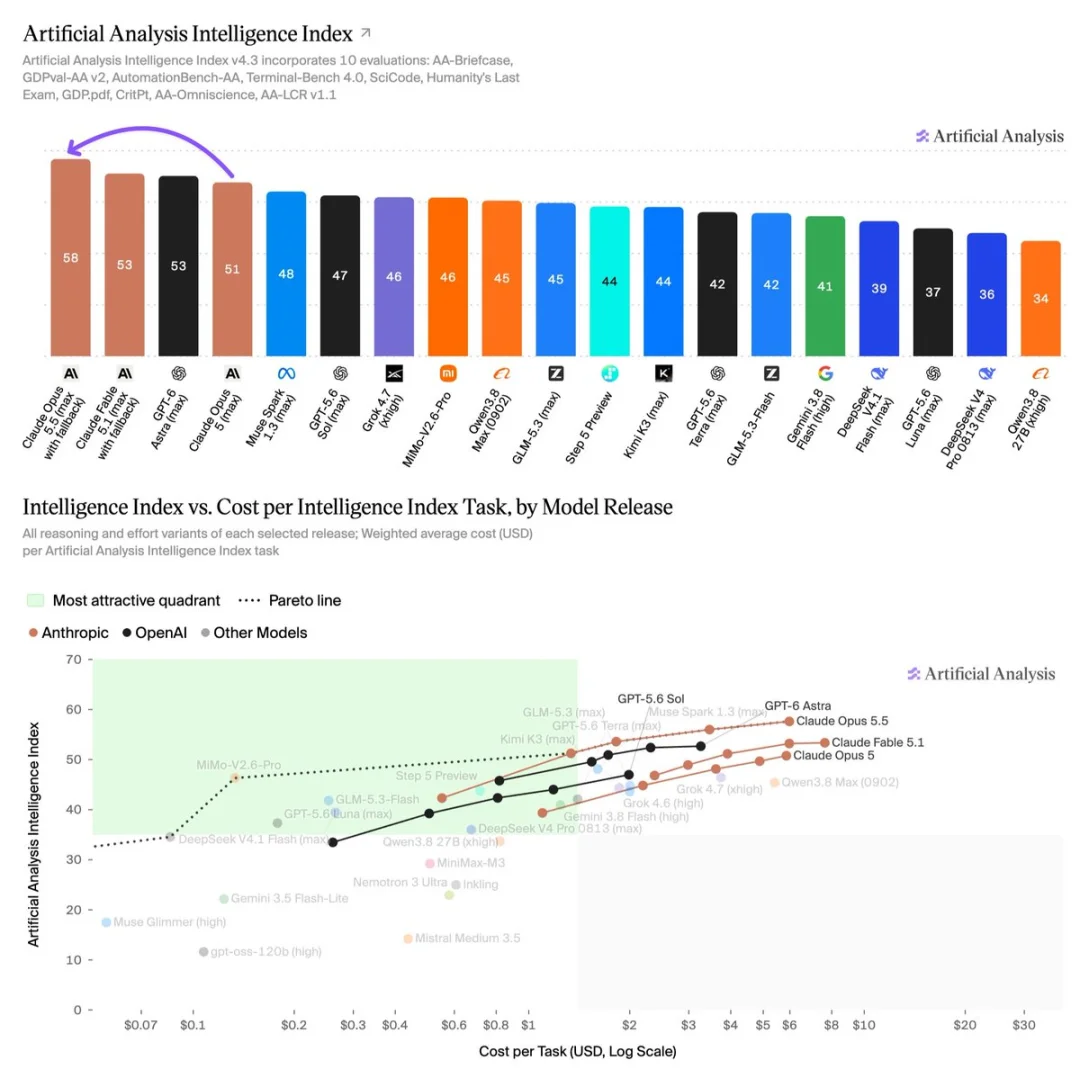
在他们的综合智能指数里,Opus 5.5 拿了 58 分,排第一,比 Fable 5.1 和 GPT-6 Astra 都高了 5 分!!
Opus 5.5 大约每题花 1.4 美元,就拿到了 Opus 5 开满档的分数,而后者每题要花 6 美元左右。
橙色那条 Opus 5.5 的线,在每个价位上都压在 Fable 5.1 和 Opus 5 上面。
顺带一提,要论每一分花多少钱,左上角最划算的是小米 MiMo-V2.6-Pro:每题只要 0.13 美元左右,就拿到了46 分,和 Grok 4.7 持平。
◈长任务依旧强大
官方还特别提到,Opus 5.5 更适合长时间独立干活。
有位测试者用它做了一个 68 万行代码的迁移,不到一天就完成了,官方说这放在以前是一个工程团队几周的工作量。
还有一个优化网页加载速度的任务,Opus 5.5 做了 40 次、成功 39 次;相比之下,Opus 5 提速没那么明显,还会顺带改坏网页原本的功能。
企业用户的反馈也很棒:
-
Stripe
一个 Opus 5.5 会话同时指挥十几个子会话干活,最后把所有冲突整理得清清楚楚,40 个改动全部通过测试; -
Chicago Trading Company
Opus 5.5 自己排查了一个 bug,想好怎么修、把代码写完,第二天早上改动已经在那儿了; -
Deloitte
代码审查时,Opus 5.5找出了72%的已知 bug,Opus 5就算开高档位也只找到 56%,而且Opus 5.5误报更少。
◈价格直接降20%,实际省40%
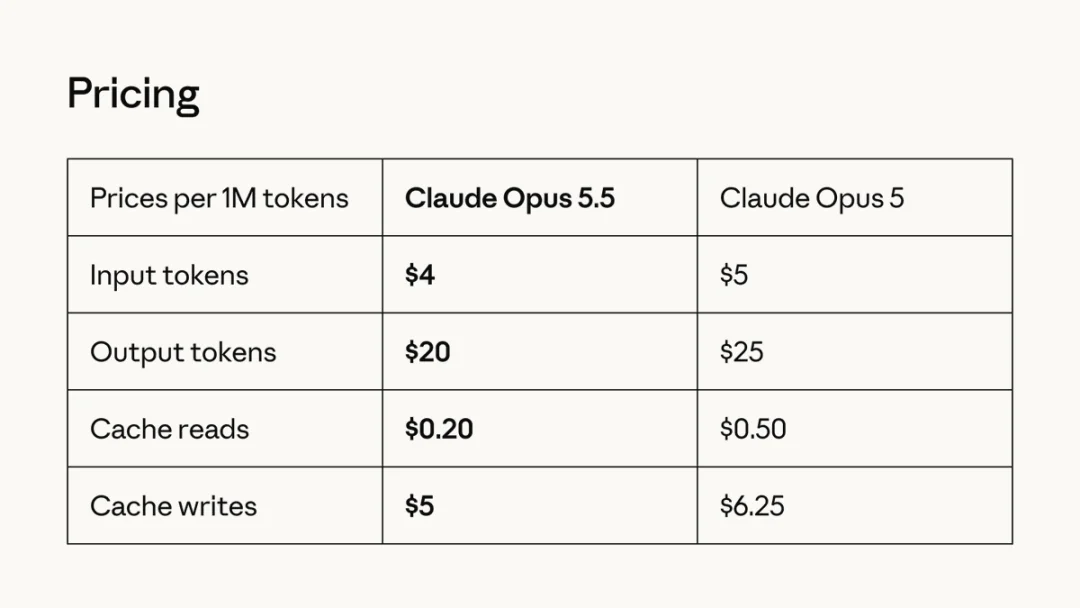
和 Opus 5 相比,价格是全线下调的:
-
输入:5 美元 → 4 美元 / 百万 token -
输出:25 美元 → 20 美元 / 百万 token -
缓存读取:0.5 美元 → 0.2 美元 / 百万 token(降了 60%) -
缓存写入:6.25 美元 → 5 美元 / 百万 token
标价降了五分之一。另外它回答同样的问题用的 token 更少,输出速度也快了30%。
两项加起来,官方说一般任务的实际花费比 Opus 5 少 40%。
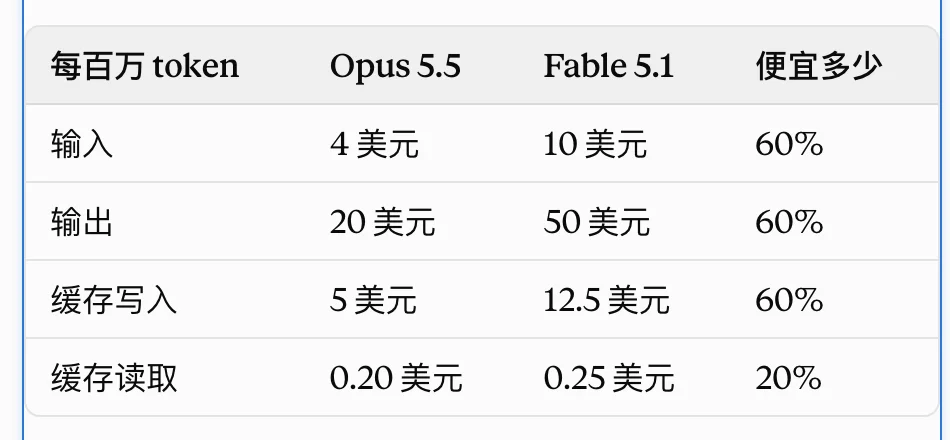
比起 Fable 5.1,Opus 5.5 更是直接便宜 60%!
还有一个 Fast 模式,价格翻倍(输入 8 美元、输出 40 美元),速度快 2.5 倍。
我实测下来,这次真的很省。
此前,Opus 5一次花百分之5周限的调研任务,这次只花了百分之一!!
One more thing,Anthropic 顺手给订阅用户发了两个福利:
-
Pro、Max、Team 套餐的五小时用量上限提高了; -
订阅用户还会拿到一次限额重置机会,可以攒着,哪天额度不够了再用。 
过去一年,新模型基本都在卷 coding。
Opus 5.5 终于换了个方向,把丢掉的写作能力捡起来了。
不过,至于这个节奏能坚持多久,就要看接下来几周的 Sonnet 5.5、Haiku 5.5,还有下一代 Fable 了。
赶紧切过去试试吧。
◈需要注意的两点
当然,这次也不是全是好消息。
一是网络安全类请求可能被悄悄换模型。 按官方说法,Opus 5.5 沿用了和 Fable 5.1 同级别的安全防护,大部分网络安全相关的任务会被路由到 Opus 4.8 处理。
二是 API 的思考过程被“保护”起来了。 8月31日之后新建的 API 账号,会默认启用 Preserved Thinking,防止蒸馏。。。
参考文献
[1] Claude 官方发布推文: https://x.com/claudeai/status/2102435511222890900
[2] Anthropic:Introducing Claude Opus 5.5: https://www.anthropic.com/claude-opus-5-5