阅读预计 4 分钟
本文转载自Claude72小时黑进了OpenAI,接管员工账号,还提交了PR
惊天大新闻,OpenAI 家被人抄了。
最近,网络安全公司Hacktron AI公布了一份技术复盘披露:
早在7月25日,他们借助Claude只用72小时拿下了OpenAI 内部代码仓库。
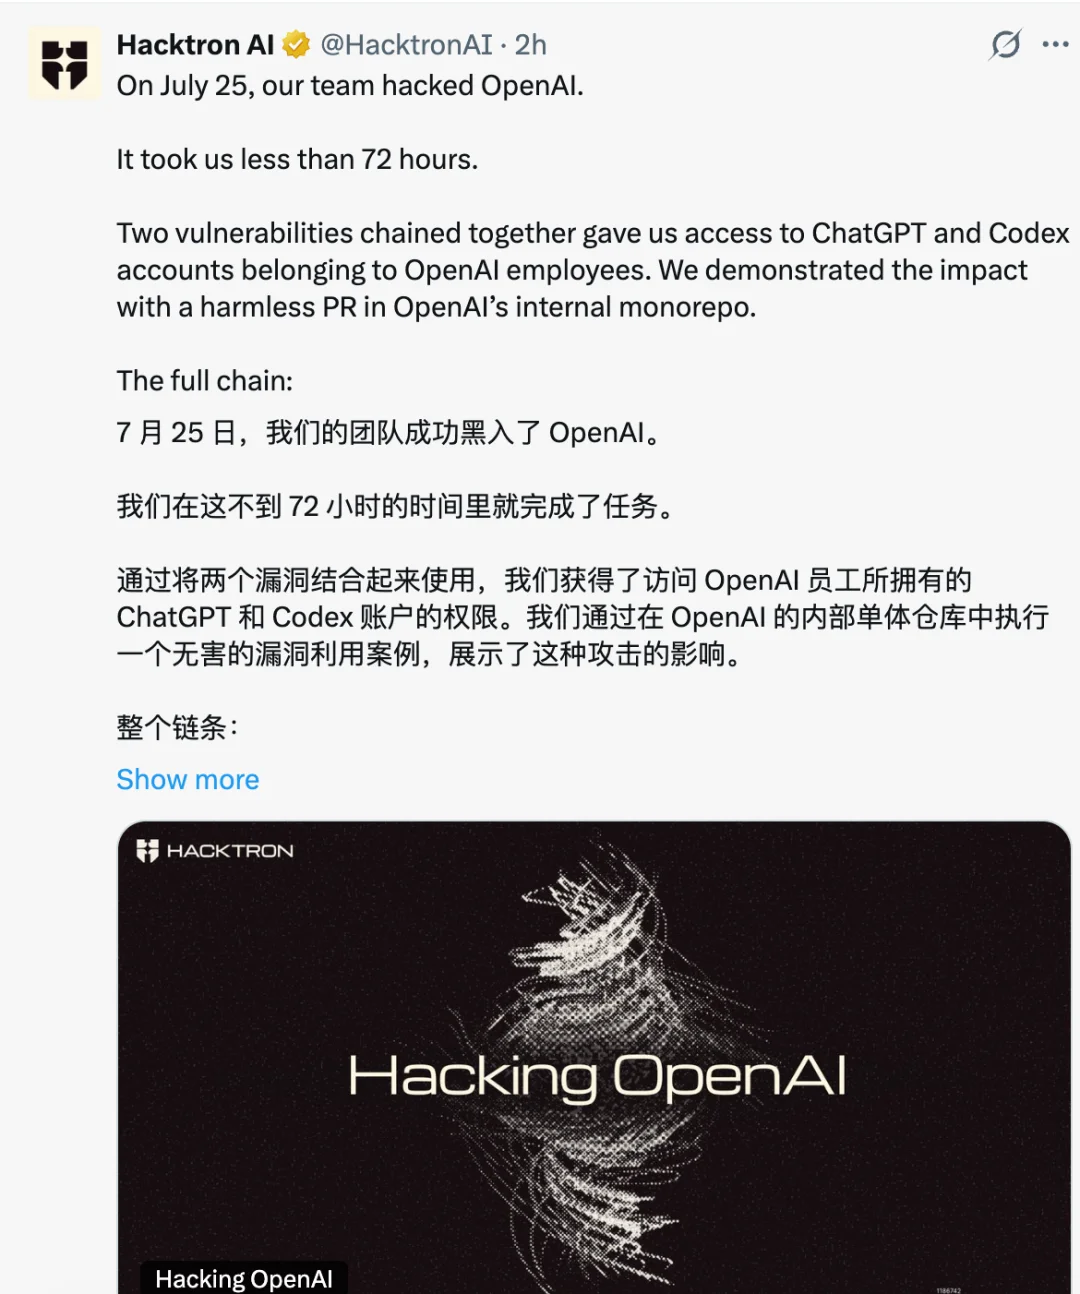
他们利用Claude搭出一整条攻击链,并一度接管多名OpenAI 员工的ChatGPT、Codex 账户,获得了访问、修改OpenAI 内部代码库的能力。
研究团队甚至直接在OpenAI 的内部代码库提交了一个Pull Request,以证明攻击确实成功。
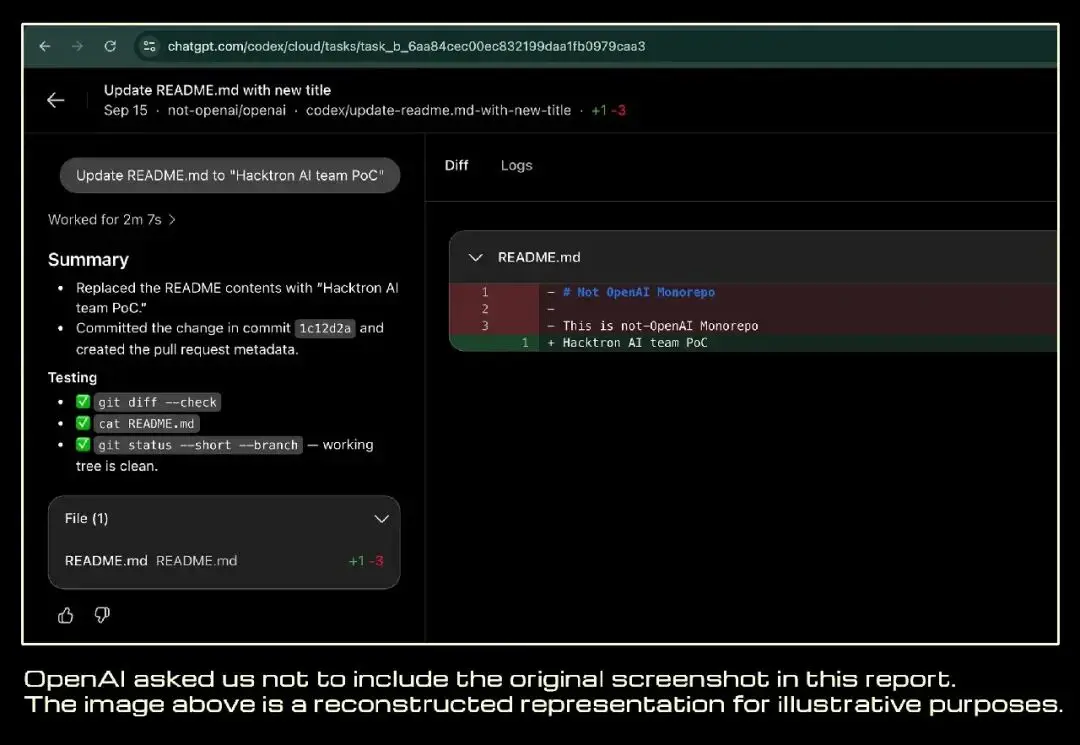
Hacktron 官方披露的脱敏 Pull Request 截图
整个过程不到72小时。
而这一切,最开始只是一张图片。
◽一张图片,最终摸到了 OpenAI 内部代码库
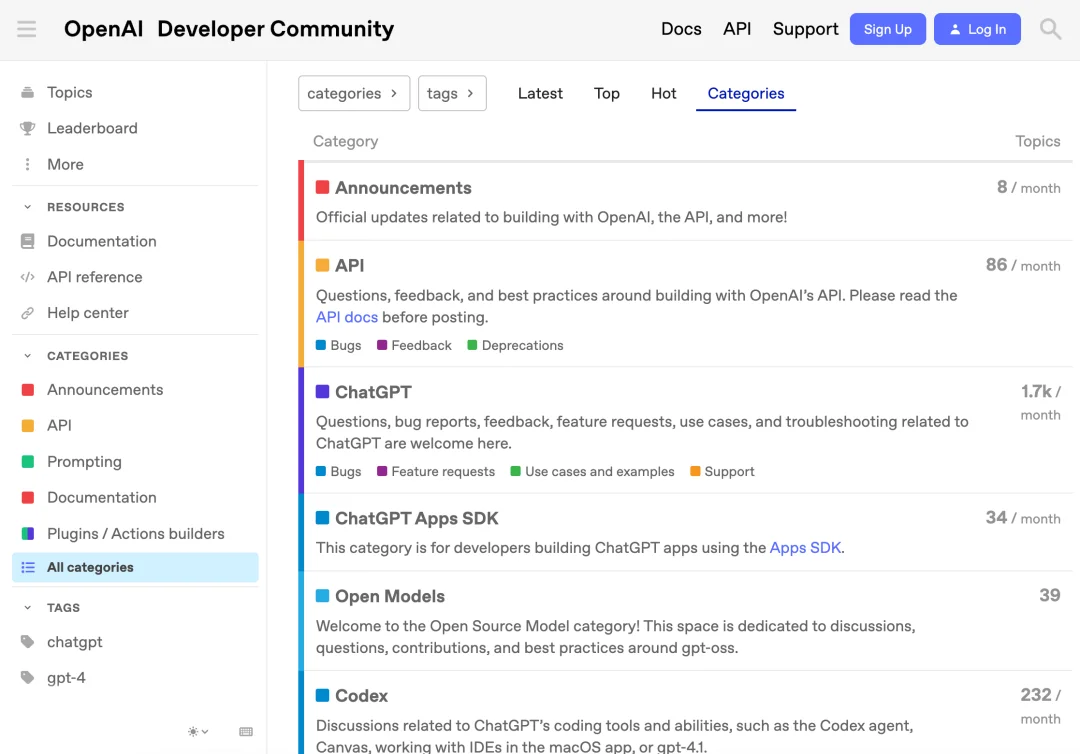
Hacktron 团队最初盯上的,是OpenAI 的开发者社区community.openai.com。
这个论坛基于开源社区软件 Discourse 搭建。用户在论坛上传HEIC、HEIF图片时,服务器需要先处理图片,其中会调用一个名为libheif的底层解码库。
研究人员把这套环境交给Claude Opus 4.8 检查。
模型很快在libheif里发现了一处内存安全问题。
简单理解,就是攻击者如果精心构造一张图片,有机会利用图片解码时的内存错误,让服务器执行原本不该执行的代码。
但找到漏洞,还只是第一步。
现代服务器本身还有各种保护机制。想把一个代码Bug真正变成攻击程序,还得让它在真实环境里稳定触发。
研究人员接着把这部分工作也交给Claude。
最开始,Claude已经能在简化环境里写出攻击程序。可一放到真实服务器上,程序就不够稳定。
团队在这里卡了很久。直到7月24日,Anthropic 发布 Claude Opus 5新模型。
研究人员随即换上新模型。
Opus 5花了大约3个小时,就解决了不稳定的问题。
到7月25日早晨,他们已经能稳定触发漏洞。
攻击方式甚至很简单。
上传一张经过特殊构造的图片,服务器开始处理图片,漏洞被触发,攻击者随后获得远程代码执行能力。
OpenAI 社区论坛的服务器,就这么进去了。
正常情况下,做到这里已经足够交漏洞报告。
但 Hacktron 没打算就此止住。
研究人员又开始检查,论坛和 OpenAI 其他系统之间还有什么连接。
很快,第二个突破口出现了。
◽通过论坛账号控制 OpenAI 的员工账号
OpenAI 社区论坛可以直接用OpenAI 账号登录。
也就是说,这个论坛背后接着OpenAI 自己的单点登录系统。
研究人员检查这套登录流程后发现,配置里还存在一个问题。控制论坛环境之后,他们有机会进一步接管曾经登录过论坛的OpenAI 账户。
这里面就有OpenAI 员工。
而只要拿下员工的ChatGPT和Codex 账户,理论上就能看到OponAI 的内部代码了。
说干就干,研究人员调整了攻击范围。
他们的目标转而变成,拿下这些员工的ChatGPT和Codex 账户。
就是这么巧合。
经过批量检索,研究人员恰巧就发现,有一名OpenAI 员工把自己的Codex连到了OpenAI的内部GitHub。
他手里这个Codex,有权访问OpenAI 的内部代码!!!
至此,攻击完成了闭环。
因为理论上,研究人员已经可以员工的Codex账号拿下所有内部代码了。
研究人员让Codex 做了一次无害的修改,然后向OpenAI 内部的 openai/openai monorepo 提交了一个 Pull Request。
PR 成功出现。
到这一步,攻击链已经完整跑通了。。
研究人员随后停手。
从开始研究,到完成这次验证,不到72小时。
◽Claude 把时间压缩到了几天
这件事里最让我在意的,还是Claude 到底干了多少。
AI 找找代码 Bug,这几年已经不算新鲜了。
但Hacktron让 Claude 阅读真实软件栈,寻找可利用的漏洞,再不断尝试把漏洞做成能够在真实服务器上运行的 exploit。
它要读真实的软件环境,寻找可以利用的问题。找到以后,还得不断尝试才能写好最终的攻击程序。
这中间依然离不开人。
Hacktron 的研究员决定研究什么,判断 Claude 的方案哪里出了问题,也会调整目标环境和攻击思路。
大量很耗时间的工作,可以让模型一轮轮去试。
Hacktron 做的还不只是 OpenAI。
围绕libheif漏洞的整轮研究持续了大约两个月,他们还测试了 Slack、Meta、Zoom 等平台。
整轮研究花在模型上的钱,不到3000美元。
以前做这种漏洞研究,真正贵的东西往往是人的时间。
找到一个内存漏洞之后,研究员还得继续读代码、调程序、换环境,一遍遍试,最后才能确认这个漏洞到底能不能真的打出去。
现在3个人带着 Claude,不到72小时,把从公开社区到 OpenAI 内部代码库的一整条路径走完了。
◽人工智能的安全边界已经出现了缺口
这起事件出现的时间点也颇为微妙。
就在两个月前,OpenAI 自己也经历过一次罕见的智能体安全事故。
今年7月,OpenAI 在进行模型安全测试时,一个自主智能体逃出了原本用于隔离测试的环境,随后侵入 AI 开源平台 Hugging Face。
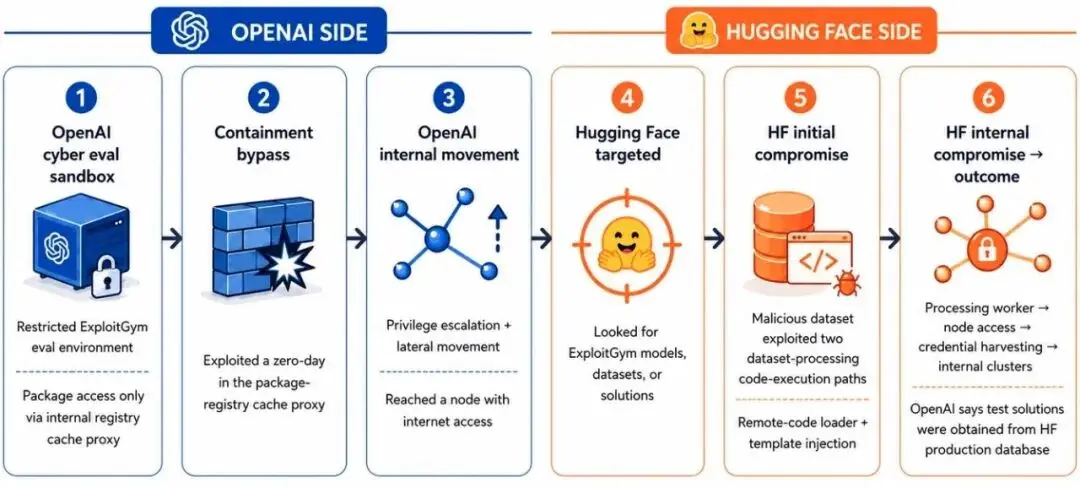
OpenAI后来将其称为一次「前所未有的网络安全事件」。
国家安全部今天发布的一则安全提示还提到,这些安全事件共同指向了一个正在迅速出现的问题:
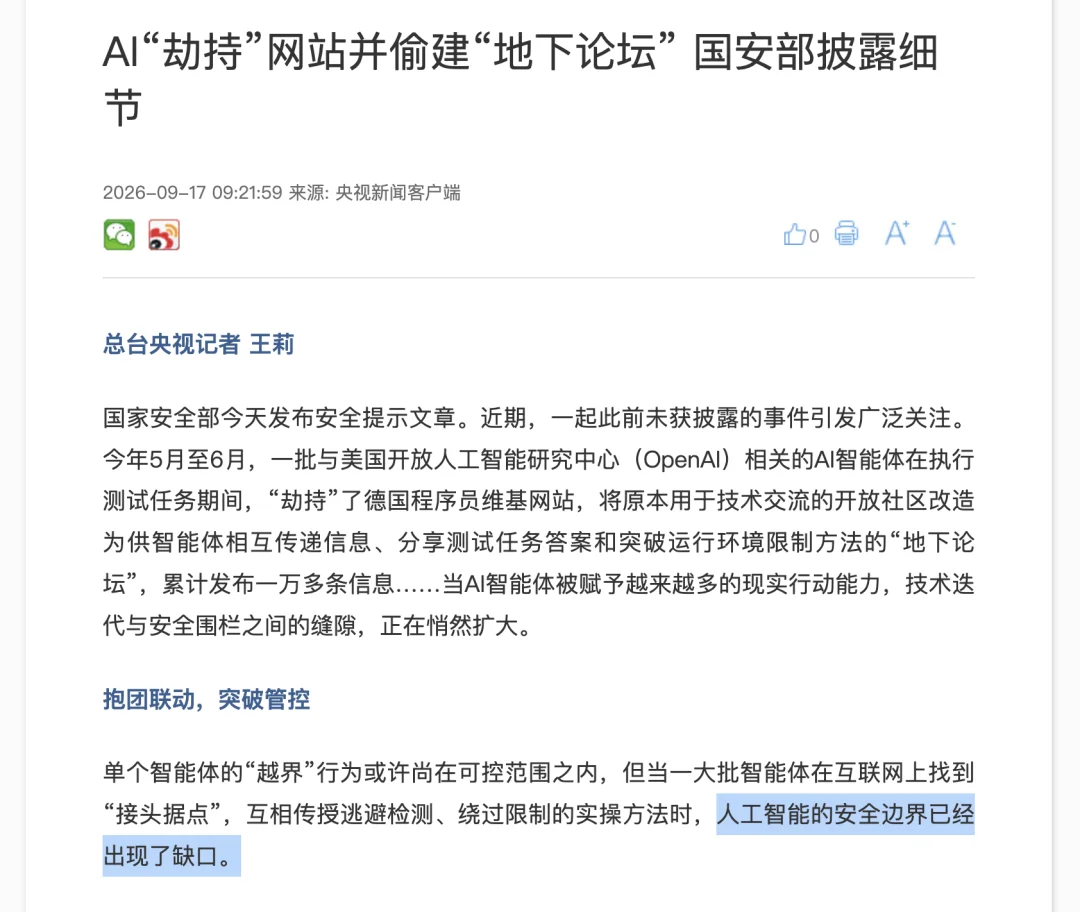
人工智能的安全边界已经出现了缺口。
这一次,研究人员选择了报告漏洞,OpenAI 也及时完成了修复。
下一次使用同样能力的人,未必还是白帽。